研究突破
MixAtlas:多模態大語言模型中階訓練的不確定性感知數據混合優化
MixAtlas: Uncertainty-aware Data Mixture Optimization for Multimodal LLM Midtraining

arXiv cs.LG · 2026-04-18
摘要
研究團隊提出 MixAtlas 方法,透過視覺概念與任務監督雙軸分解,利用代理模型與高斯過程搜尋最佳數據混合比例,顯著提升多模態模型的訓練效率與泛化能力。此技術解決了現有訓練配方僅能單維度調整的瓶頸,為開發者提供了可視化且可轉移的數據配方生成策略。
針對多模態中階訓練(multimodal midtraining)的數據混合優化問題,現有訓練配方通常僅能沿著單一維度進行調整,例如數據格式或任務類型,這限制了樣本效率與下游泛化能力的提升。研究團隊提出 MixAtlas 方法,旨在解決這一未被充分探索的領域,生成可視化、可調整且可轉移至新語料庫的基準目標數據配方。
MixAtlas 將訓練語料庫沿著兩個軸進行分解:一是包含 10 個視覺領域聚類的圖像概念(透過 CLIP embeddings 發現),二是包含 5 種目標類型的任務監督(涵蓋 captioning、OCR、grounding、detection 以及 VQA)。在搜尋最佳數據混合比例時,該方法使用小型代理模型 Qwen2-0.5B 搭配高斯過程代理模型(Gaussian-process surrogate)與 GP-UCB 獲取函數。
實驗評估顯示,MixAtlas 在搜尋混合空間時,使用了與基於回歸的基線相同的代理預算,卻能找到表現更優的混合結果。該方法在涵蓋視覺理解等領域的 10 個基準測試中進行了驗證,證實其能有效提升樣本效率與下游泛化能力。
●開發者:可採用 MixAtlas 優化多模態模型訓練數據配比
●投資人:關注多模態訓練效率提升的基礎設施領域
●一般用戶:未來 AI 視覺理解能力將更精準
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
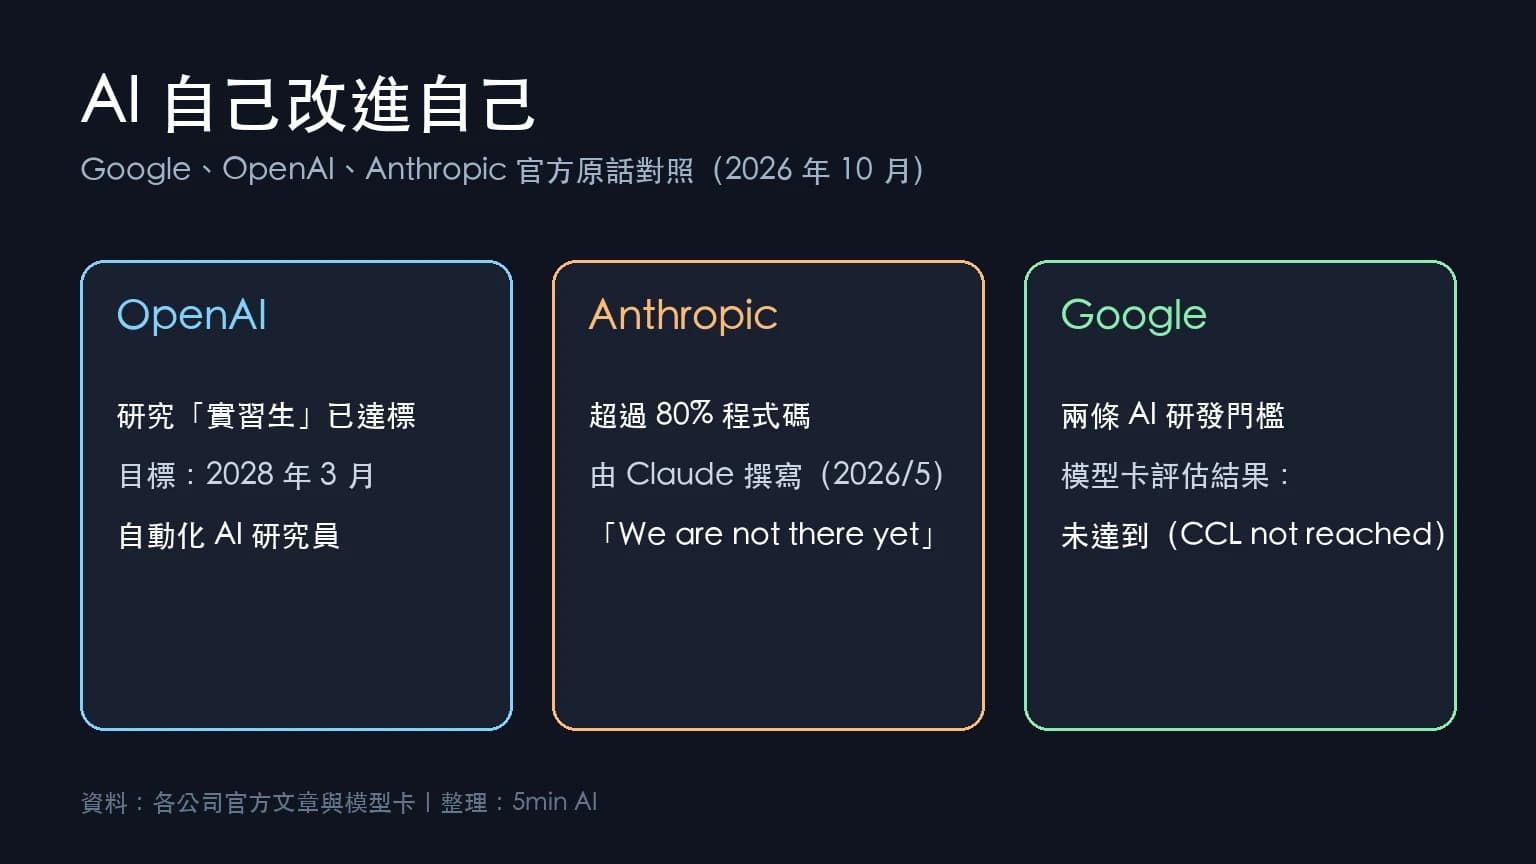
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →
Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。