研究突破
PolyKV:多智能體 LLM 推理的共享非對稱壓縮 KV 快取池
PolyKV: A Shared Asymmetrically-Compressed KV Cache Pool for Multi-Agent LLM Inference

arXiv cs.LG · 2026-04-29
摘要
研究團隊推出 PolyKV 系統,讓多個並行推理智能體共享單一的非對稱壓縮 KV 快取池,而非傳統的逐智能體分配方式。系統採用非對稱壓縮策略——Keys 量化至 int8 以保持 softmax 穩定性,Values 則用 TurboQuant MSE 壓縮至 3 位元。在 Llama-3-8B 上運行 15 個智能體時,能將 KV 快取記憶體從 19.8 GB 降至 0.45 GB,達成穩定的 2.91 倍壓縮比,有助於降低多智能體推理的成本和延遲。
研究團隊提出 PolyKV 系統,讓多個並行推理智能體共享單一的非對稱壓縮 KV 快取池,改變傳統為每個智能體分配獨立 KV 快取的標準範式。PolyKV 將壓縮後的快取寫入一次,並透過 HuggingFace DynamicCache 物件注入至 N 個獨立的智能體情境中。該系統在壓縮策略上採用非對稱方式:Keys 量化為 int8 (q8_0) 以維持 softmax 穩定性,Values 則使用 TurboQuant MSE 壓縮至 3 位元,此方法包含 Fast Walsh-Hadamard Transform (FWHT) 旋轉以及經過針對 N(0,1) 調整的 3 位元 Lloyd-Max 量化。
研究在 SmolLM2-1.7B-Instruct 與 Llama-3-8B-Instruct 兩種模型規模上進行評估,涵蓋 600 至 7,194 tokens 的三種情境長度,並支援最多 15 個並行智能體。PolyKV 在所有配置下達成穩定的 2.91 倍壓縮比。以 Llama-3-8B 搭配 15 個智能體共享 4K-token 情境為例,系統將 KV 快取記憶體從 19.8 GB 降至 0.45 GB,實現 97.7% 的記憶體削減。
在效能表現方面,PolyKV 僅造成 +0.57% 的困惑度 (perplexity) 下降,平均 BERTScore F1 維持在 0.928。困惑度差異 (PPL delta) 不會隨智能體數量增加而擴大,且隨著情境長度增加而改善,在 1,851 個相干 tokens 時甚至逆轉為 -0.26%。據研究團隊表示,目前尚無其他工作結合單一共享的有損壓縮 KV 池與多讀取器並行智能體存取。
●開發者:可應用於多智能體系統優化,減少推理資源消耗
●投資人:LLM 推理效率技術突破,降低營運成本
●一般用戶:對話服務更快更便宜,多智能體應用體驗改善
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南 →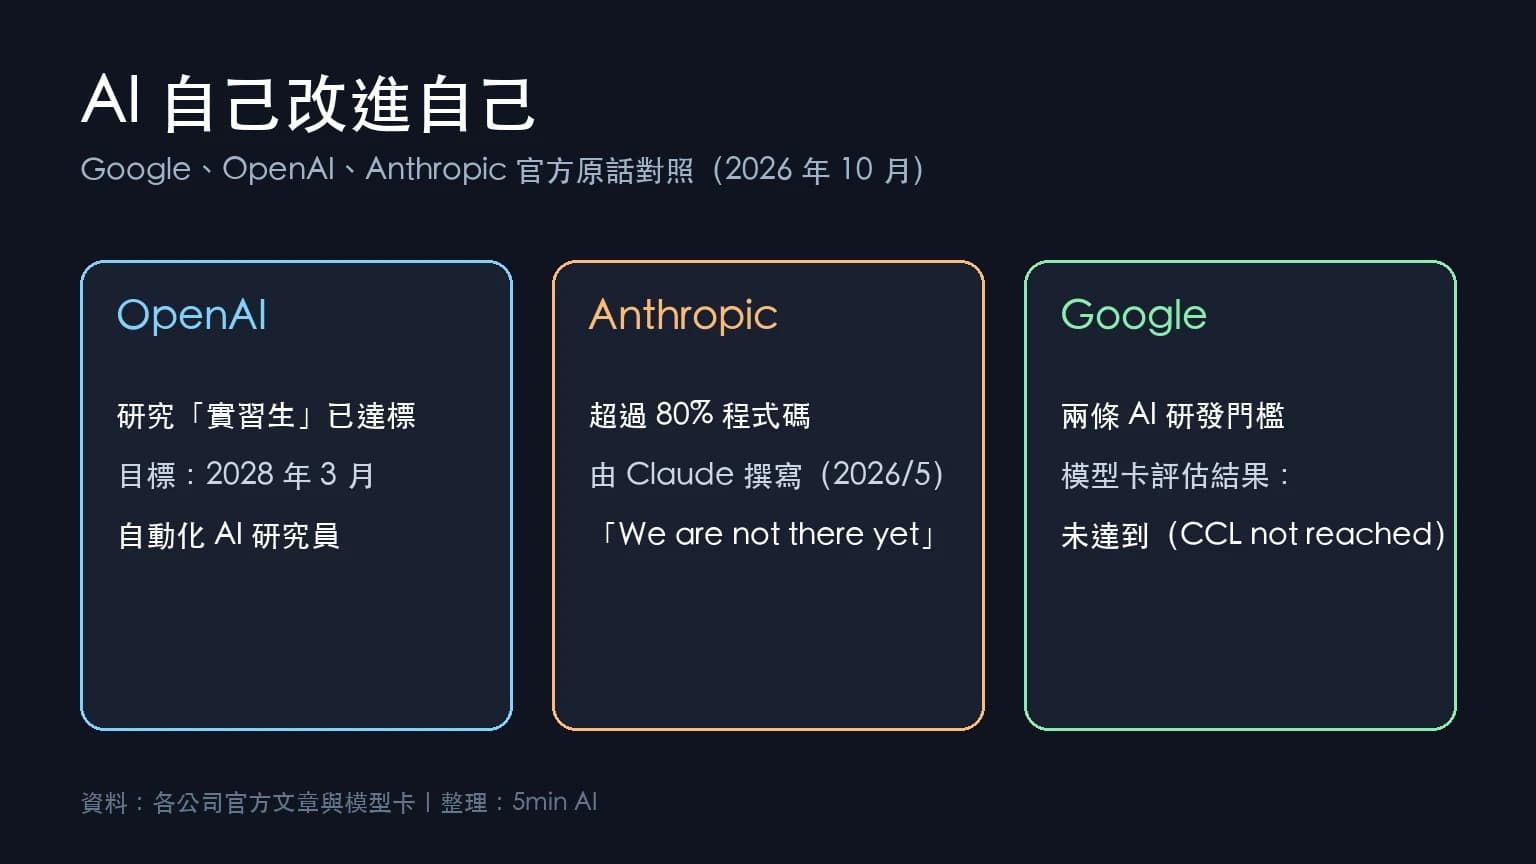
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →
Notion AI vs NotebookLM:AI 筆記與會議記錄工具比較
Notion AI vs NotebookLM 深度比較:分析兩款 AI 筆記軟體的會議記錄、知識管理與價格差異,協助你找到最適合的 AI 筆記軟體推薦。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。