研究突破
Anthropic 發佈關於 AI 對齊的最新研究和進展。該...
Alignment
Anthropic Blog2026-05-02
摘要
Anthropic 發佈關於 AI 對齊的最新研究和進展。該文章深入探討如何確保大型語言模型的行為與人類價值觀和意圖保持一致,這是開發安全可靠 AI 系統的核心課題。
●開發者:可深入了解 Claude 模型的對齊機制和最佳實踐
●投資人:Anthropic 在 AI 安全領域的技術優勢和差異化競爭力
●一般用戶:確保使用的 AI 助手更可信和安全
重要性評分
75/100
🟠 值得關注
AI對齊Anthropic模型安全
原文出處喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Anthropic Claude 生態
Anthropic Claude 生態系全景圖:從 API 到 Agent SDK 完整路線圖
解析 Anthropic Claude 生態系:現行 Claude 模型、Claude API 的速率限制與上下文視窗、七種語言的官方 SDK、Agent SDK 與 MCP,整理從 API 到 Agent 開發的完整路線圖。
閱讀指南
LLM 模型安全
LLM 模型安全與倫理實戰:2026 年企業合規與風險管理指南
2026 年企業如何確保 LLM 模型安全?本指南涵蓋 AI 倫理規範、企業 AI 合規策略及模型紅隊測試實戰步驟,協助建立安全的 AI 部署環境。
閱讀指南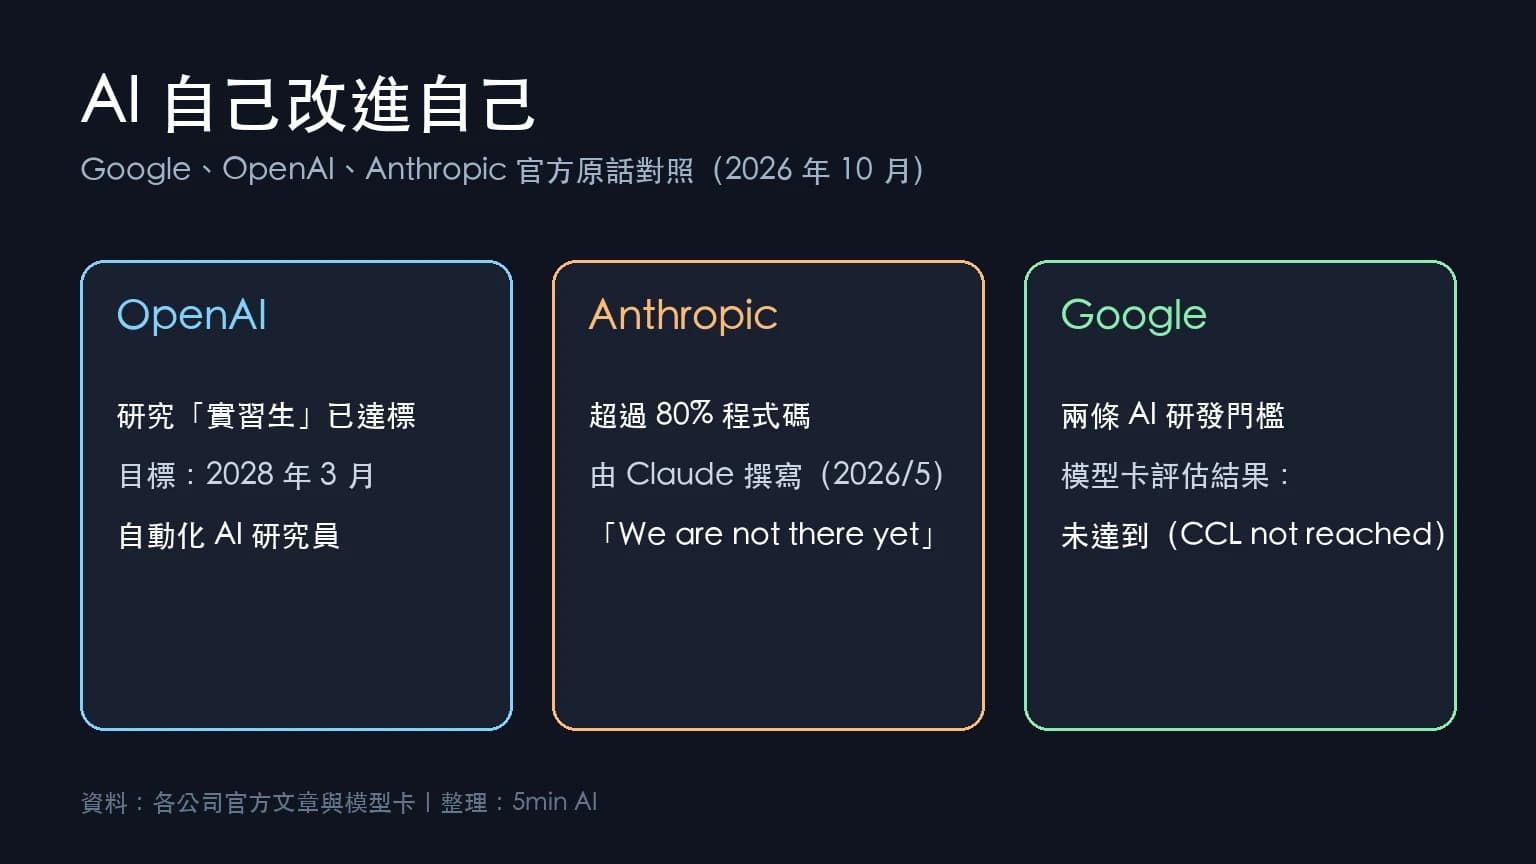
AI 自我改進 RSI
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。