研究突破
CLEAR:揭示噪聲和歧義如何破壞 LLMs 在醫療應用中的可靠性
CLEAR: Revealing How Noise and Ambiguity Degrade Reliability in LLMs for Medicine
arXiv cs.CL · 2026-05-05
摘要
研究團隊推出 CLEAR 框架,系統性地評估決策空間呈現、歧義和不確定性如何影響 LLMs 在醫療任務上的表現。測試發現,當可選答案增加時,模型識別正確答案和正確拒答的能力會明顯下降,且當拒答選項的措辭從明確的「以上皆非」轉變為含糊的表述時,這種問題會更加惡化。
●開發者:應重視在醫療 LLM 評估中引入真實世界的歧義和不確定性
●投資人:醫療 AI 系統的可靠性和安全性評估標準仍待完善,存在投資風險
●一般用戶:醫療 AI 應用的現有評估方法不夠充分,實際應用時需保持警惕
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

LLM 模型安全與倫理實戰:2026 年企業合規與風險管理指南
2026 年企業如何確保 LLM 模型安全?本指南涵蓋 AI 倫理規範、企業 AI 合規策略及模型紅隊測試實戰步驟,協助建立安全的 AI 部署環境。
閱讀指南 →
Internal Safety Collapse 是什麼?揭開 AI 模型越強大越危險的 95.3% 失敗率真相
深入解析 Internal Safety Collapse (ISC) 是什麼?探討為何 AI 模型越強大越容易崩潰,揭露 95.3% 的失敗率數據,以及對 AI 模型安全性的具體影響與未來挑戰。
閱讀指南 →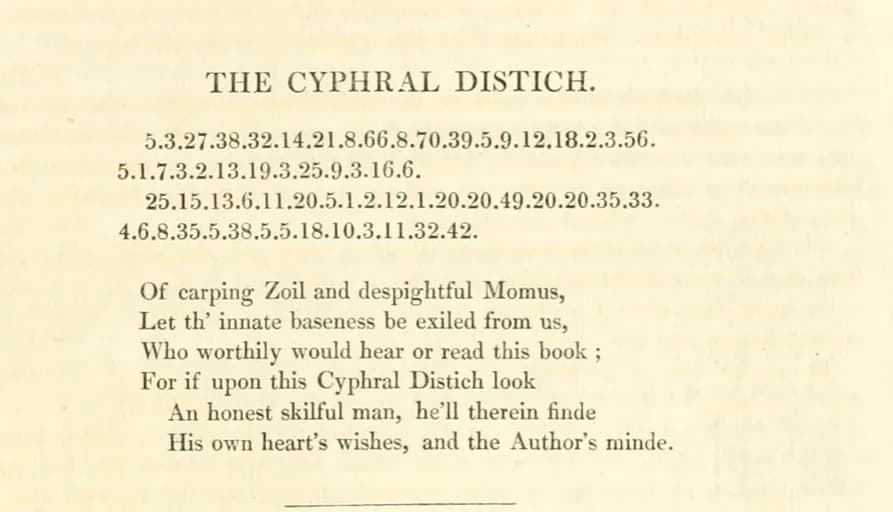
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。