研究突破
多智能體推理提升計算效率:Pareto 最優測試時間縮放
Multi-Agent Reasoning Improves Compute Efficiency: Pareto-Optimal Test-Time Scaling
arXiv cs.AI2026-05-06
摘要
研究團隊系統性分析了自洽性、自精進、多智能體辯論和混合智能體等四種推理方法,在不增加模型訓練的前提下提升預測準確性。透過在 MMLU-Pro 和 BBH 兩個基準上進行超過 100 次評估,研究發現多智能體推理方法能在計算成本最低的情況下達到最佳精準度,準確率最高可提升 7.1%,為資源受限的實際應用提供了成本效益的推理策略。
研究團隊針對語言模型在不增加訓練成本下提升預測能力的四種推理方法進行了系統性分析,這四種方法分別為自洽性(self-consistency)、自精進(self-refinement)、多智能體辯論(multi-agent debate)以及混合智能體(mixture-of-agents)。研究重點在於探討這些方法在計算效能與成本之間的權衡,以解決資源受限的實際應用問題。
研究團隊在 MMLU-Pro 和 BBH 兩個推理基準上進行了超過 100 次的評估,涵蓋了 34 種不同的參數配置,包括平行預測數量、智能體數量及辯論輪次的擴展。透過計算帕雷托最優前緣(Pareto-optimal front),團隊選出了在最低計算預算下達成最佳準確度的方法。結果顯示,在 MMLU-Pro 基準上,當計算預算達到鏈式思考(chain-of-thought)的 20 倍時,推理擴展技術的準確率最高可提升 7.1 個百分點。
在相同的計算預算下,多智能體辯論與混合智能體方法的表現優於自洽性,分別高出 1.3 個百分點和 2.7 個百分點。研究發現,自洽性方法較早達到飽和,而多智能體方法則在更複雜的任務上持續獲得增益。基於此,研究提出了一項簡單的多智能體設計準則:當平行生成的數量超過序列聚合的數量時,混合智能體是最有效率的设计。
●開發者:可採用多智能體推理策略優化推理成本,無需重新訓練模型
●投資人:計算效率突破將降低 AI 應用部署成本,擴大商業化機會
●一般用戶:後續應用可在相同硬體資源下提供更快更準確的回應
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
閱讀指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南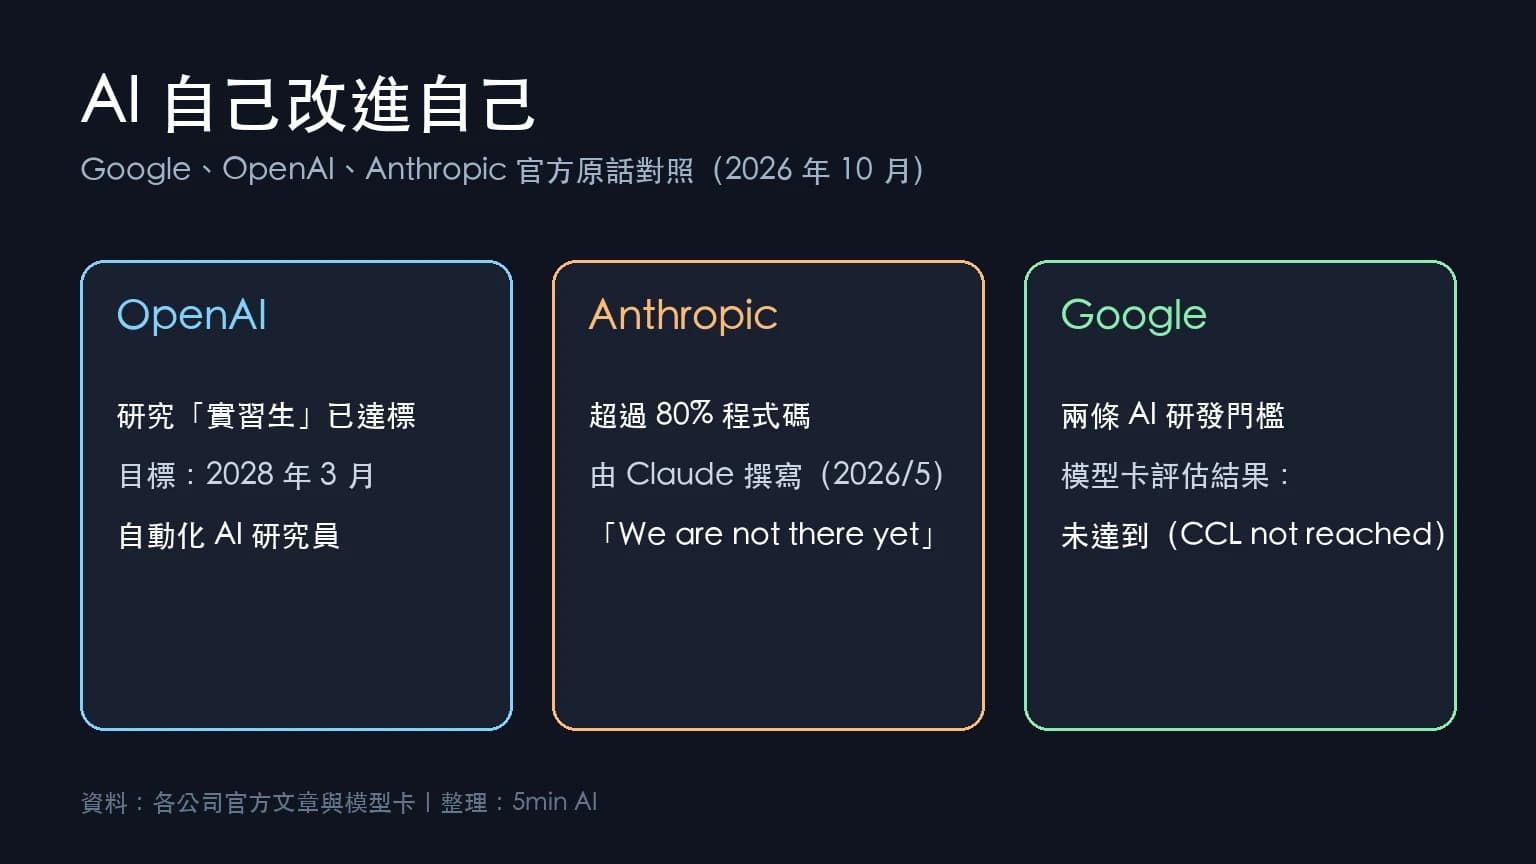
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。