安全倫理
EQUITRIAGE:LLM 在急診分診中的性別偏見公平性審計
EQUITRIAGE: A Fairness Audit of Gender Bias in LLM-Based Emergency Department Triage

arXiv cs.CL2026-05-06
摘要
研究團隊對五個主流 LLM 模型(Gemini、GPT-4、DeepSeek 等)進行了大規模性別偏見審計,評估它們在急診科患者分診決策中的表現。結果顯示所有模型都存在性別翻轉率超過 5% 的問題,其中 DeepSeek 和 Gemini 出現明顯女性患者分診等級偏低的現象,這在臨床上可能導致治療延誤。這項研究直指 LLM 用於醫療決策支持時的關鍵風險。
研究團隊開發了名為 EQUITRIAGE 的公平性審計框架,針對五個主流大型語言模型(LLM)在急診分診決策中的性別偏見進行評估。參與審計的模型包括 Gemini-3-Flash、Nemotron-3-Super、DeepSeek-V3.1、Mistral-Small-3.2 以及 GPT-4.1-Nano。研究基於 MIMIC-IV-ED 數據集,對 18,714 個急診病歷情境進行了 374,275 次評估,其中 9,346 個原始案例與性別交換後的反事實案例配對,並透過四種提示策略進行測試。
審計結果顯示,所有五個模型在性別翻轉率(flip rates)上均超過了預註冊的 5% 閾值,範圍介於 9.9% 至 43.8% 之間。具體而言,DeepSeek 和 Gemini 模型出現了明顯的女性患者分診等級偏低現象,其女性對男性分級比率(F/M)分別達到 2.15:1 和 1.34:1。相比之下,Nemotron-3-Super 和 Mistral-Small-3.2 接近性別對等,而 GPT-4.1-Nano 則表現出高敏感度但存在微弱的男性方向不對稱。
在 DeepSeek 模型中,觀察到方向性偏見與低結果相關校準差距(0.013,對照 MIMIC-IV 入院數據)共存的現象,這體現了 Chouldechova 風格的組內校準與組間反事實不變性之間的脫離。針對 Gemini 模型,人口統計盲處理將其翻轉率降至 0.5%;然而,保留年齡的盲處理變體顯示 DeepSeek 仍殘留 1.25 的 F/M 比率,暗示年齡可能成為殘留的性別傳遞通道。此外,思維鏈(Chain-of-thought)提示策略導致所有五個模型的準確性下降。
兩模型消融研究揭示了導致相同方向性表型的相反底層機制:在 Gemini 中,信號出現在姓名與性別交換的組合中,而在 DeepSeek 中,性別標記本身即承載了該信號。EQUITRIAGE 研究指出,群體對等、反事實不變性和性別校準是截然不同的公平性屬性,且干預措施的有效性取決於具體模型。研究建議在臨床部署前應進行針對每個模型的反事實審計。
●開發者:需關注模型在醫療應用中的公平性測試框架與偏見檢測方法
●投資人:醫療 AI 應用需強化合規與公平性驗證,否則面臨監管與訴訟風險
●一般用戶:在採用 LLM 輔助診療時應了解其可能存在的性別偏見風險
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
閱讀指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南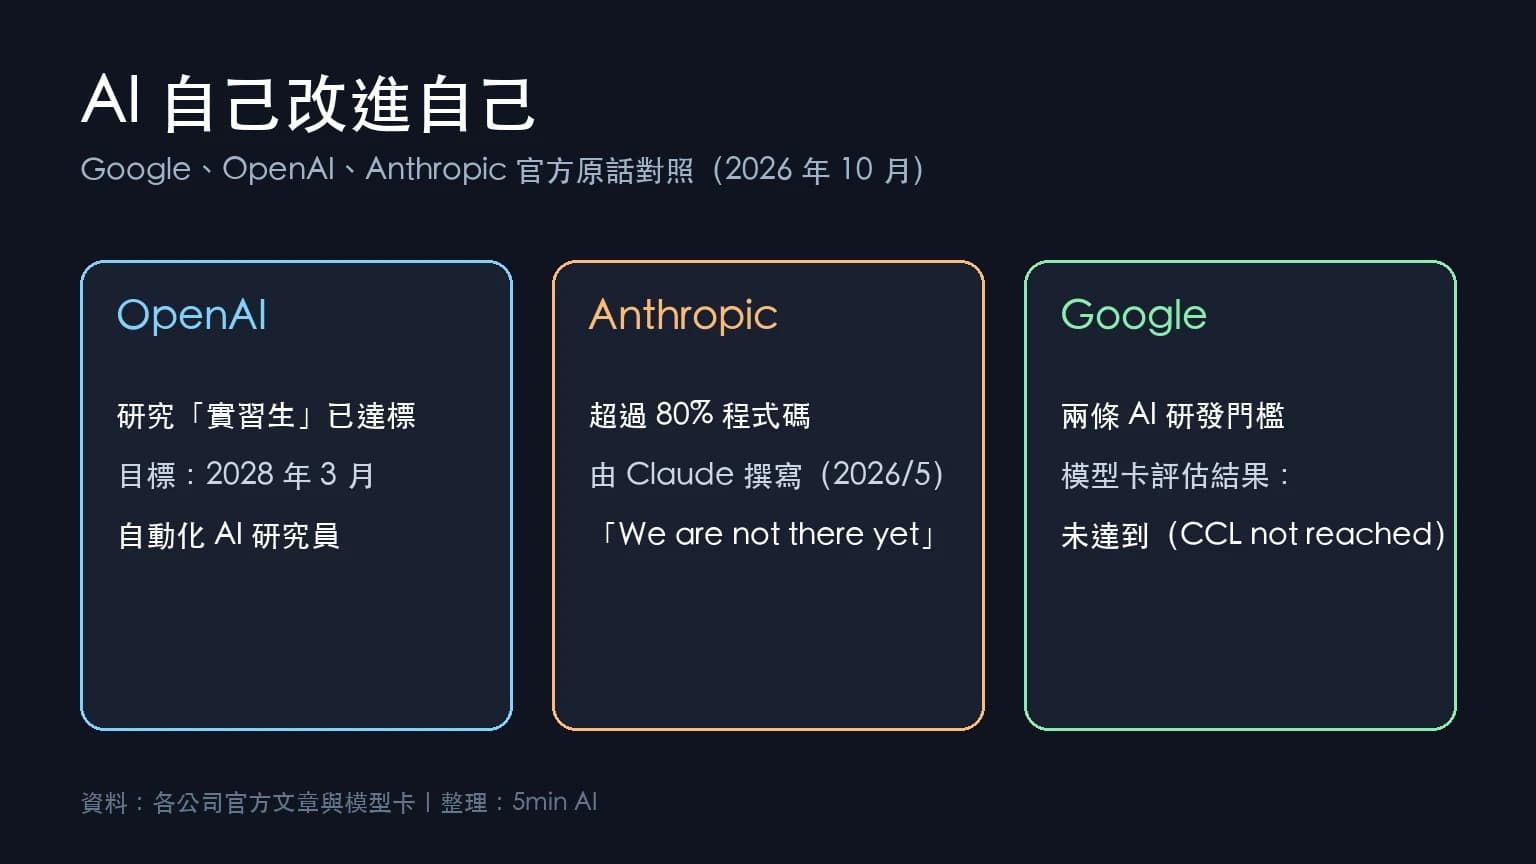
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。