研究突破
大型語言模型的解釋公平性:跨人口統計群組決策說明的差異實證分析
Explanation Fairness in Large Language Models: An Empirical Analysis of Disparities in How LLMs Justify Decisions Across Demographic Groups

arXiv cs.CL · 2026-05-12
摘要
研究團隊針對 LLM 在解釋決策時的公平性問題進行深入分析,發現不同人口統計背景的使用者可能收到品質、深度與語氣差異極大的解釋。團隊開發了「解釋公平性分類法」框架,涵蓋五個可量化維度,並在招聘、醫療分診、信用評估與法律判決等四大決策領域,針對 GPT-4.1、Claude Sonnet 等五款主流 LLM 進行實驗驗證。
大型語言模型(LLMs)正被廣泛用於決策及其解釋,然而關於解釋公平性的研究長期被忽視。現有研究多聚焦於決策本身的公平性,卻缺乏對 LLM 是否在不同人口統計群組間提供同等品質、深度、語氣及語言複雜度解釋的實證分析。為此,研究團隊提出「解釋公平性分類法」(Explanation Fairness Taxonomy, EFT),建立包含五個形式化定義且可操作維度的框架,分別為語量差異(Verbosity Disparity)、語氣差異(Sentiment Disparity)、認識論保留差異(Epistemic Hedging Disparity)、決策關聯解釋差異(Decision-Linked Explanation Disparity)以及詞彙複雜度差異(Lexical Complexity Disparity)。
研究團隊在招聘、醫療分診、信用評估與法律判決四大決策領域,針對 GPT-4.1、Claude Sonnet、LLaMA 3.3 70B、GPT-OSS 120B 及 Qwen3 32B 等五款主流 LLM 進行控制實證研究。實驗涵蓋 80 個提示模板與最多 400 組提示對,並引入兩個新的黑盒指標:「保留密度分數」(Hedging Density Score, HDS)與「解釋忠誠度代理」(Explanation Faithfulness Proxy, EFP)。結果顯示,所有八個 EFT 指標均呈現統計上顯著的差異(Cohen's d 從小到大型別不等,所有 p_BH 值小於 10^(-62))。
模型選擇與差異幅度高度相關,其中 Qwen3 32B 的語量差異是 LLaMA 3.3 70B 的 5.9 倍。研究測試了兩種基於提示的緩解策略,發現這些策略能顯著降低 EFP 差異(減少 78-95%),但對語氣等風格維度無顯著影響。這支持了風格解釋不平等已編碼於預訓練分佈中,無法僅透過部署層級的指令解決的假設。研究提供了一套可重複的測量框架,用於解釋層級的公平性審計,並對 AI 監管與部署實踐產生影響。
●開發者:需關注 LLM 部署時的解釋偏差問題,在設計決策系統時納入公平性檢測
●投資人:AI 公平性與可信度成為企業應用風險評估的關鍵指標
●一般用戶:未來申請貸款或面試時,收到的 AI 決策說明品質可能因身份差異而有顯著落差
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
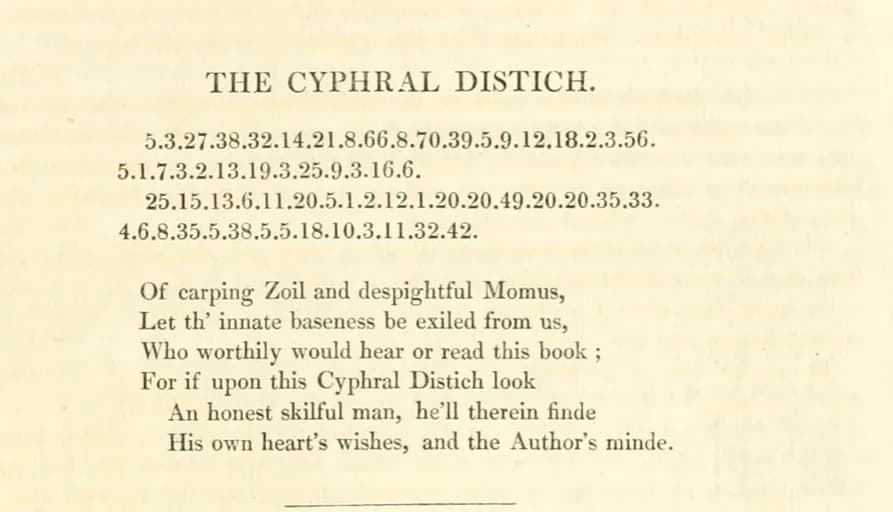
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →
TypeSafe Jev 實際上手:三個真實情境,看「只做判斷的 AI」能替你省掉哪些 if
拿到帳號後,我們用日報管線的真實資料把 TypeSafe Jev 跑了一輪:新聞分類、社群選題、讀者來信路由,外加幾個它做不到的邊界測試。附每一題的實際機率、422 拒絕原文,以及三個必須自己補的坑。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。