研究突破
Robust LLM Unlearning Against Relearning Attacks:表示幾何中的次要成分很關鍵
Robust LLM Unlearning Against Relearning Attacks: The Minor Components in Representations Matter

arXiv cs.CL · 2026-05-13
摘要
研究人員發現現有的 LLM 遺忘方法存在重大安全漏洞——被遺忘的知識可透過再學習攻擊迅速恢復。團隊從表示幾何角度深入分析,發現問題根源在於現有方法只優化主導成分,而次要成分更能抵抗知識恢復。這項發現對保護開源模型的隱私和安全具有重要指導意義。
大型語言模型(LLM)的遺忘技術旨在移除預訓練模型中的特定數據影響,以解決隱私、版權和安全問題,但無需昂貴的重新訓練。然而,近期研究揭示了一項關鍵漏洞:被遺忘的模型會透過再學習攻擊迅速恢復「遺忘」的知識,這種脆弱性對開放權重模型構成了嚴重的安全隱患。
研究團隊從表示幾何的角度深入調查了這種脆弱性的根本機制,發現現有的遺忘方法主要沿著主導成分進行優化,而次要成分幾乎保持不變。理論分析指出,在再學習攻擊期間,主導成分中的修改容易被反轉,從而實現知識的快速恢復;相比之下,次要成分對這種反轉表現出更強的抵抗力,其根源在於表示的光譜結構。
基於這一發現,研究團隊提出了次要成分遺忘(Minor Component Unlearning, MCU)這一新方法,該方法明確針對表示中的次要成分。通過將遺忘效果集中在這些固有堅固的方向上,MCU 顯著提高了對再學習攻擊的抵抗力。在三個數據集上進行的廣泛實驗驗證了該方法的有效性,顯示其性能顯著優於包括銳度感知最小化(sharpness-aware minimization)在內的最先進方法。
●開發者:需重新評估遺忘機制設計,並在次要表示成分上加強優化策略
●投資人:LLM 安全防護領域存在新的技術機會
●一般用戶:影響未來 AI 模型隱私保護的可靠性
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
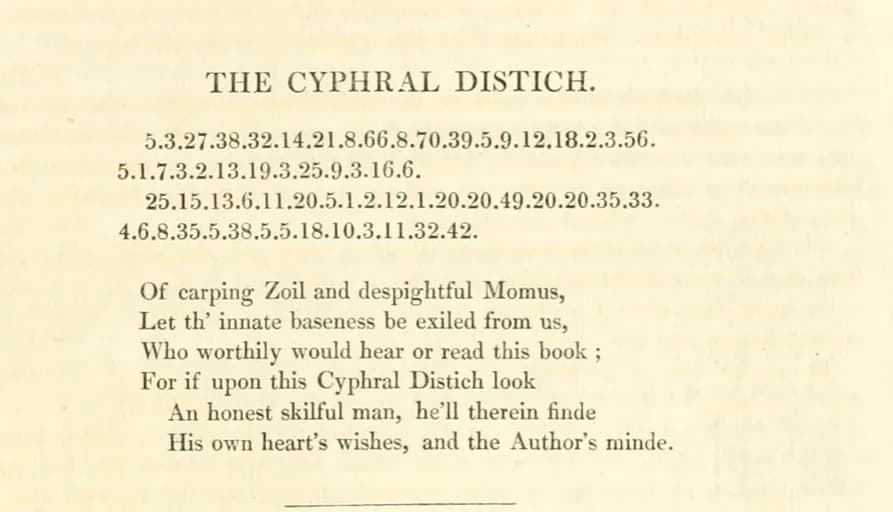
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →
TypeSafe Jev 實際上手:三個真實情境,看「只做判斷的 AI」能替你省掉哪些 if
拿到帳號後,我們用日報管線的真實資料把 TypeSafe Jev 跑了一輪:新聞分類、社群選題、讀者來信路由,外加幾個它做不到的邊界測試。附每一題的實際機率、422 拒絕原文,以及三個必須自己補的坑。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。