開發工具
Real-time LLM Inference on Standard GPUs:每秒 3000 tokens 的推理速度
Real-time LLM Inference on Standard GPUs: 3k tokens/s per request
Hacker News · 2026-05-29
摘要
研究者展示了在標準 GPU 上實現 LLM 實時推理的方案,達到每秒 3000 tokens 的吞吐量。這項進展降低了大型語言模型的部署門檻,讓中小企業和個人開發者無需購置高端專業級硬體就能運行大型模型,具有重要的實用價值。
●開發者:可以用消費級 GPU 部署實時 LLM 服務,降低基礎設施成本
●投資人:推理優化是 AI 成本競爭的關鍵,相關技術和方案具備商業潛力
●一般用戶:AI 應用部署成本下降,本地運行 LLM 的可能性增加
重要性評分
76/100
🟠 值得關注
LLM 推理優化GPU 推理實時推理
原文出處喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

google ai studio vibe coding 教學
Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
perplexity vs chatgpt
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →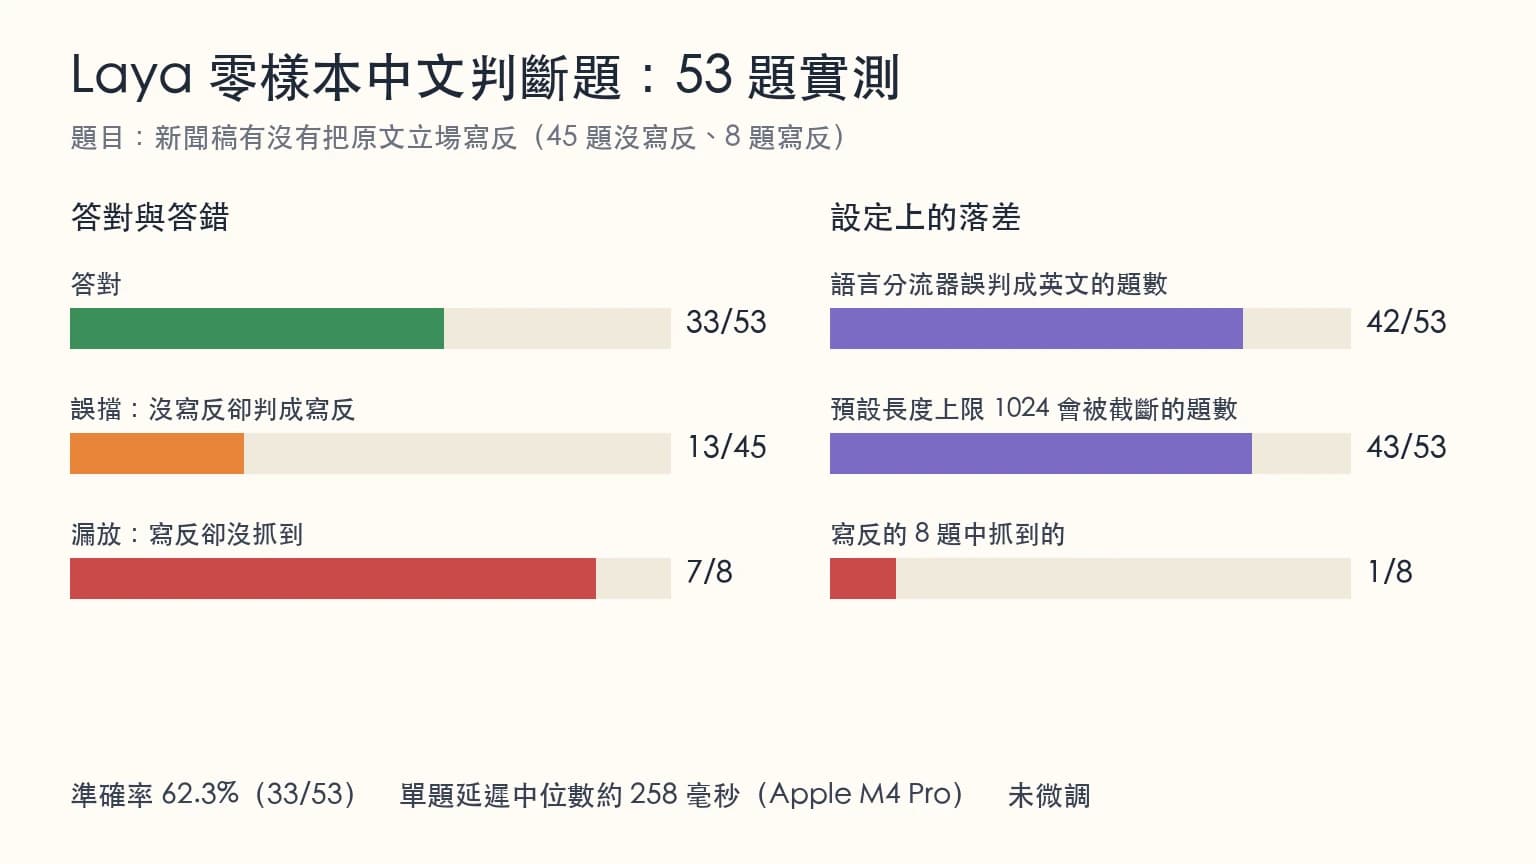
Laya 開源模型
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。