研究突破
EHRBench:用於臨床決策的自動化可靠電子病歷基準測試
EHRBench: An Automated and Reliable EHR-based Benchmark for Clinical Decision Making with LLMs
arXiv cs.AI · 2026-06-01
摘要
研究團隊推出 EHRBench,一個基於真實電子病歷(EHR)的自動化基準測試框架,用於評估 LLM 在臨床決策中的可靠性。該基準透過自動化管道確保規模與品質兼具,讓研究者能在診斷推理、治療選擇等實際臨床任務上測試 LLM 模型的表現。
●開發者:可參考 EHRBench 框架評估自家 LLM 在醫療領域的可用性
●投資人:醫療 AI 應用的可靠性測試變得更系統化,降低了臨床部署的風險
●一般用戶:有助確保未來由 AI 輔助的臨床決策工具更加可信與安全
重要性評分
75/100
🟠 值得關注
臨床決策電子病歷LLM評估
原文出處喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

google ai studio vibe coding 教學
Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
perplexity vs chatgpt
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →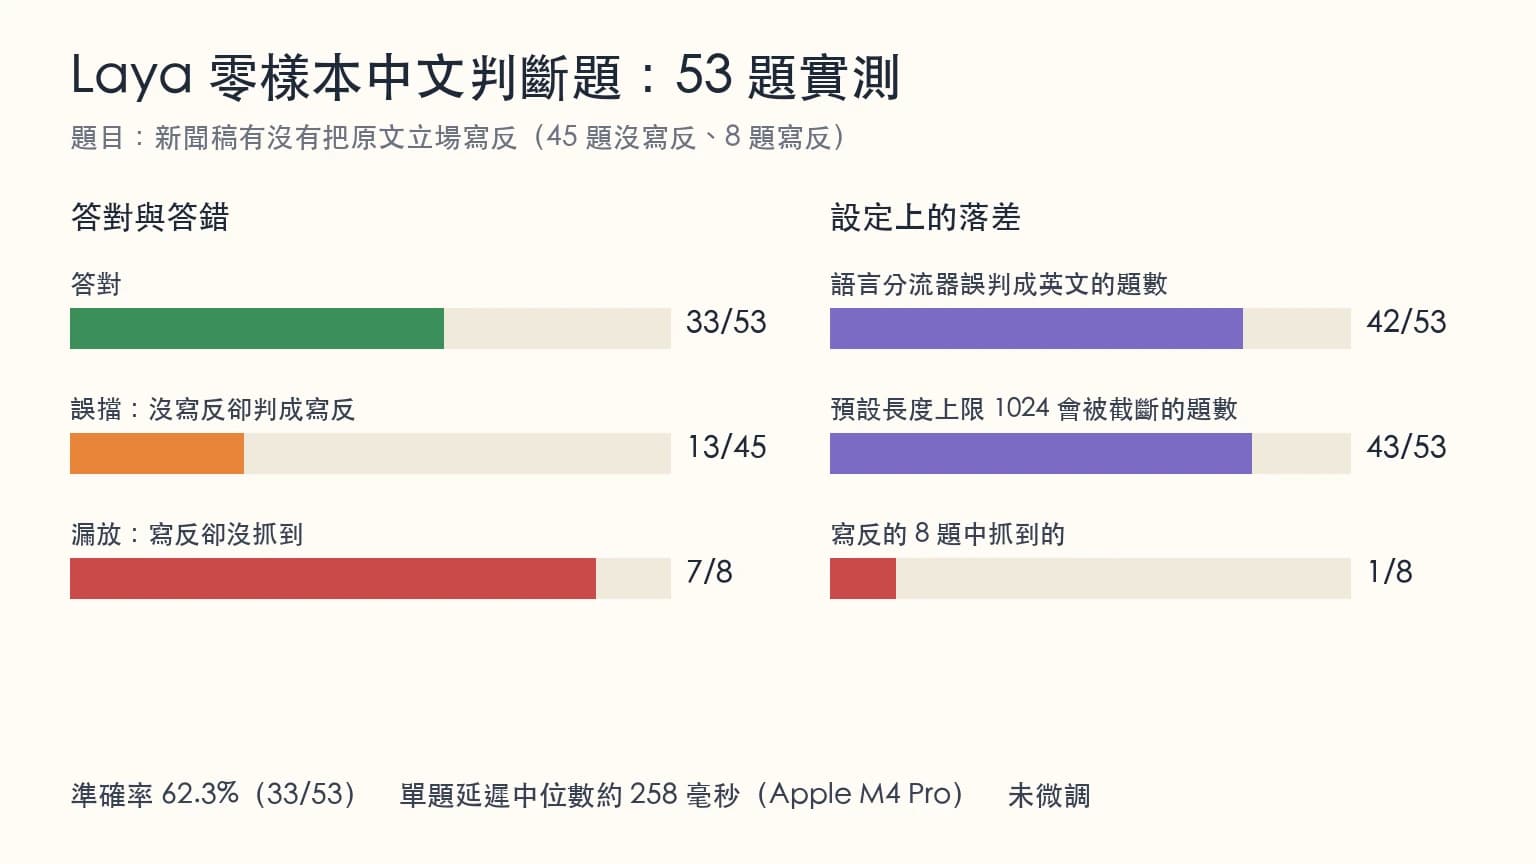
Laya 開源模型
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。