安全倫理
Anthropic Responsible Scaling Policy 負責任擴展政策
Responsible Scaling Policy

Anthropic Blog2026-06-21
摘要
Anthropic 發布了負責任擴展政策,闡述在開發更強大 AI 模型時如何安全地進行規模化。這項政策強調在技術進步與安全考量間取得平衡,是 AI 業界在模型擴展道路上的重要規範指南。
●開發者:有助於理解模型開發的安全最佳實踐
●投資人:反映 Anthropic 對 AI 安全的堅持立場,提升業界信心
●一般用戶:確保未來的 AI 產品在強大的同時更加安全可靠
重要性評分
75/100
🟠 值得關注
AnthropicAI 安全模型擴展
原文出處上一則← Anthropic 的 Frontier Red Team:前沿 AI 模型安全測試團隊下一則7,000 台 Langflow 伺服器遭攻擊,LangGraph 與 LangChain 存在相同漏洞 →
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Anthropic Claude 生態
Anthropic Claude 生態系全景圖:從 API 到 Agent SDK 完整路線圖
解析 Anthropic Claude 生態系:現行 Claude 模型、Claude API 的速率限制與上下文視窗、七種語言的官方 SDK、Agent SDK 與 MCP,整理從 API 到 Agent 開發的完整路線圖。
閱讀指南
AI 安全 2026
2026 生成式 AI 安全實戰:企業防範與倫理指南
解析 2026 AI 安全策略,提供企業防範生成式 AI 風險的實戰步驟,涵蓋歐盟 AI Act 時程、安全合規檢查與 AI 倫理規範落地做法,幫助企業打造可信任的 AI 應用。
閱讀指南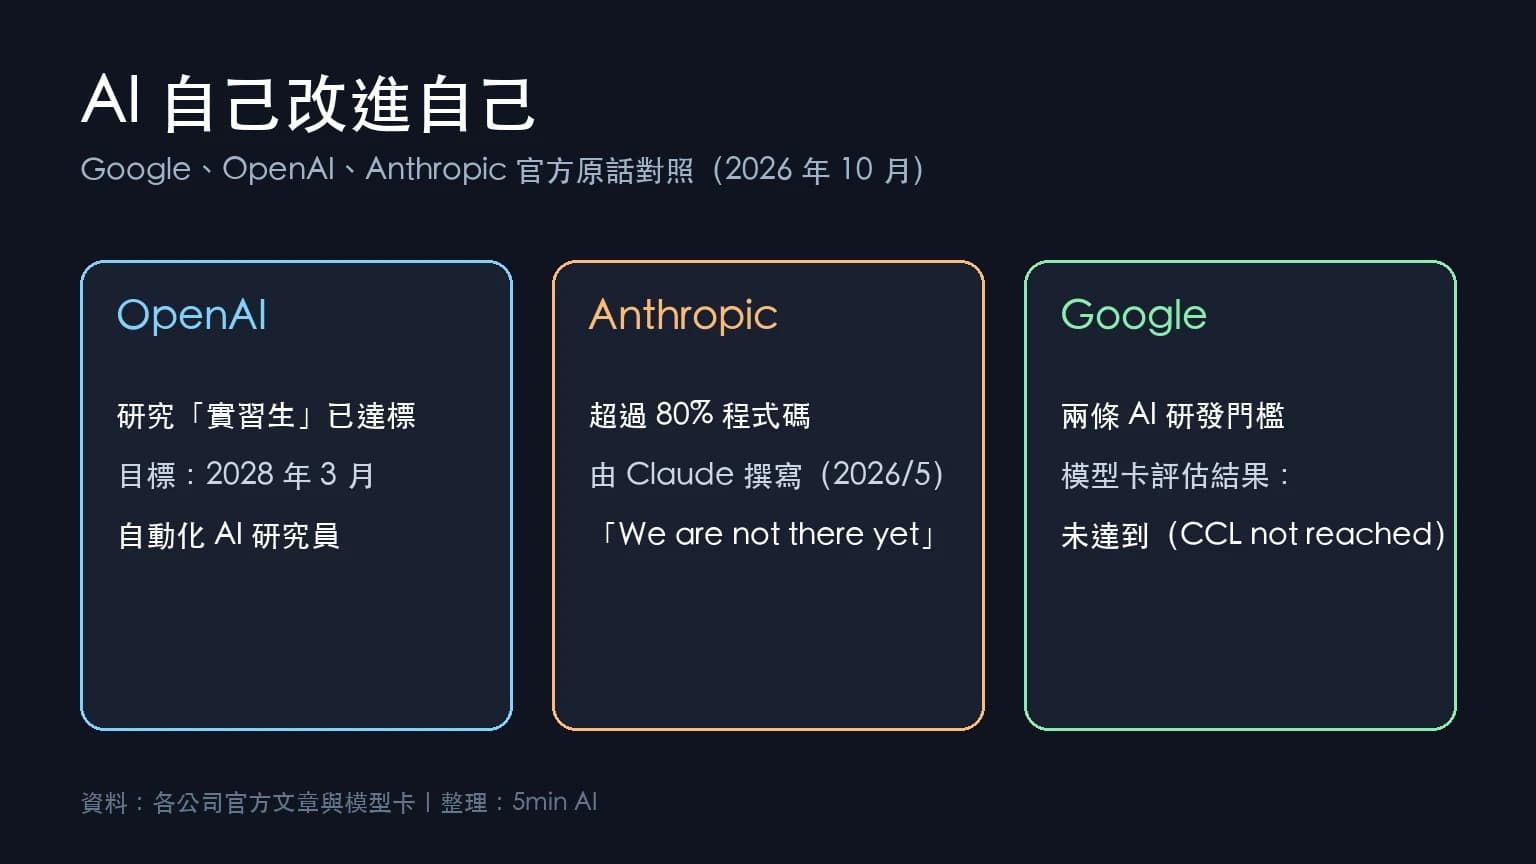
AI 自我改進 RSI
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。