研究突破
Anthropic 的 AI 模型對齊(alignment)研究團隊與方向
Alignment
每天早上一封信,5 分鐘看完 AI 重點。5min AI 是繁體中文的每日 AI 新聞整理,免費、可隨時取消。

Anthropic Blog2026-06-28
摘要
Anthropic 設有專責 AI 模型對齊(alignment)的研究團隊,致力於改進 AI 系統與人類價值觀的對齊方式,讓 Claude 等 AI 模型更安全、更可靠、更有幫助。對齊是確保 AI 行為符合人類意圖的關鍵環節,也是 Anthropic 負責任開發 AI 的核心方向。
●開發者:可了解最新的 AI 安全對齊技術,應用於自家模型開發
●投資人:對齐技術進展是 Anthropic 核心競爭力,影響其長期商業價值
●一般用戶:更安全可靠的 AI 助手體驗即將實現
重要性評分
78/100
🟠 值得關注
AI 對齐模型安全Anthropic
原文出處每天早晨收到值得看的 AI 重點。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Anthropic Claude 生態
Anthropic Claude 生態系全景圖:從 API 到 Agent SDK 完整路線圖
解析 Anthropic Claude 生態系:現行 Claude 模型、Claude API 的速率限制與上下文視窗、七種語言的官方 SDK、Agent SDK 與 MCP,整理從 API 到 Agent 開發的完整路線圖。
閱讀指南
LLM 模型安全
LLM 模型安全與倫理實戰:2026 年企業合規與風險管理指南
2026 年企業如何確保 LLM 模型安全?本指南涵蓋 AI 倫理規範、企業 AI 合規策略及模型紅隊測試實戰步驟,協助建立安全的 AI 部署環境。
閱讀指南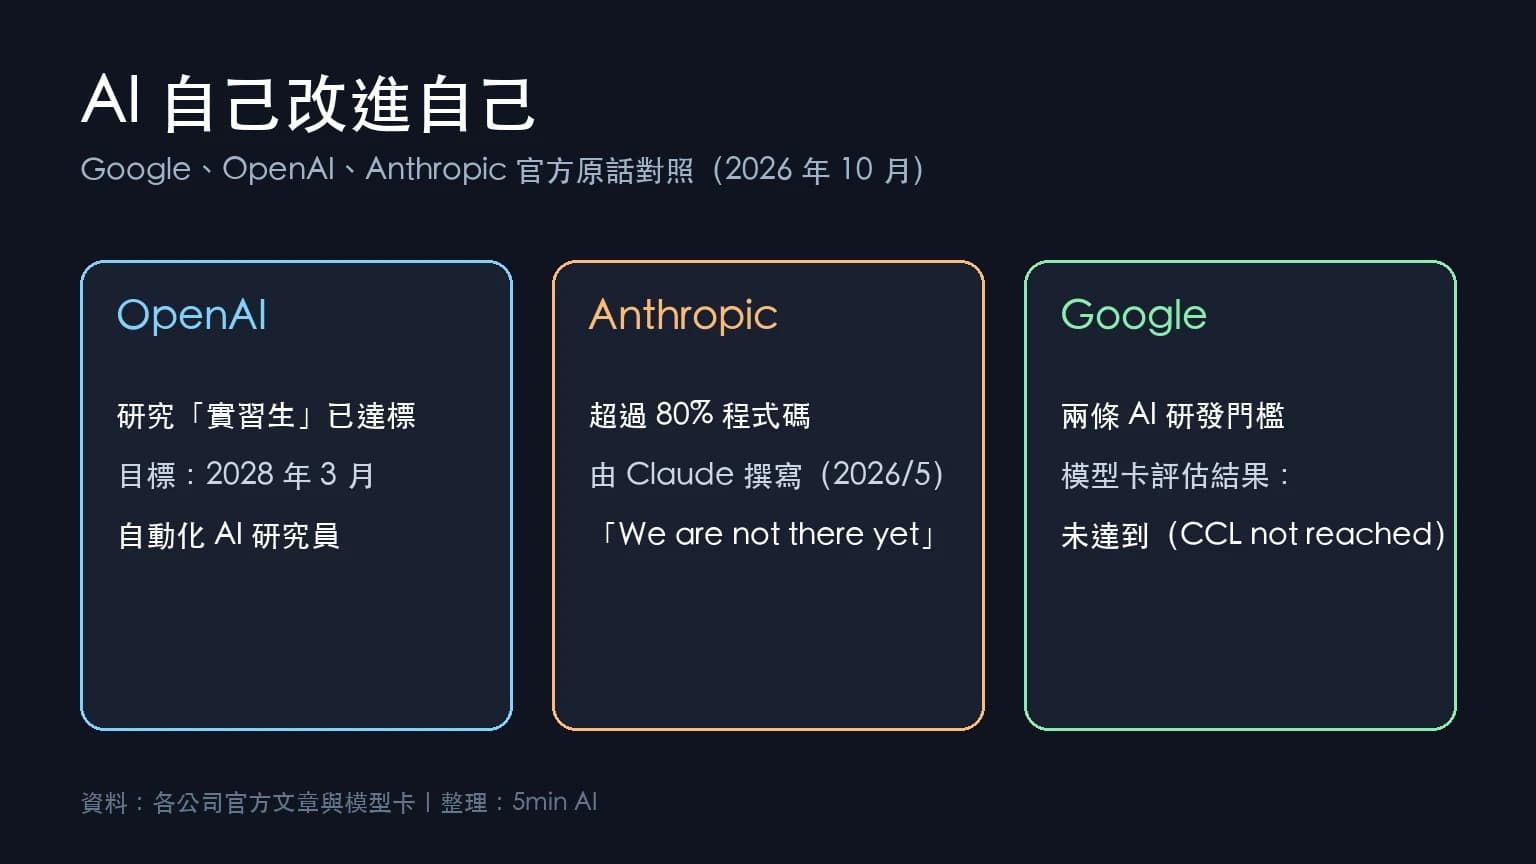
AI 自我改進 RSI
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。