安全倫理
Anthropic 的 Frontier Red Team:前沿 AI 模型安全測試團隊
Frontier Red Team
每天早上一封信,5 分鐘看完 AI 重點。5min AI 是繁體中文的每日 AI 新聞整理,免費、可隨時取消。

Anthropic Blog2026-06-29
摘要
Anthropic 的 Frontier Red Team 是針對最先進 AI 模型進行系統性安全測試與對抗評估的團隊,目標是在模型部署前識別潛在風險與漏洞,推進 AI 安全研究並確保模型的可靠性與可信度。
●開發者:可關注 Anthropic 的安全測試方法論與最佳實踐
●投資人:AI 安全與合規成為產品競爭差異化因素,值得重視
●一般用戶:意味著使用的 AI 工具經過更嚴格的安全驗證
重要性評分
76/100
🟠 值得關注
AI安全Anthropic對抗測試
原文出處每天早晨收到值得看的 AI 重點。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Anthropic Claude 生態
Anthropic Claude 生態系全景圖:從 API 到 Agent SDK 完整路線圖
解析 Anthropic Claude 生態系:現行 Claude 模型、Claude API 的速率限制與上下文視窗、七種語言的官方 SDK、Agent SDK 與 MCP,整理從 API 到 Agent 開發的完整路線圖。
閱讀指南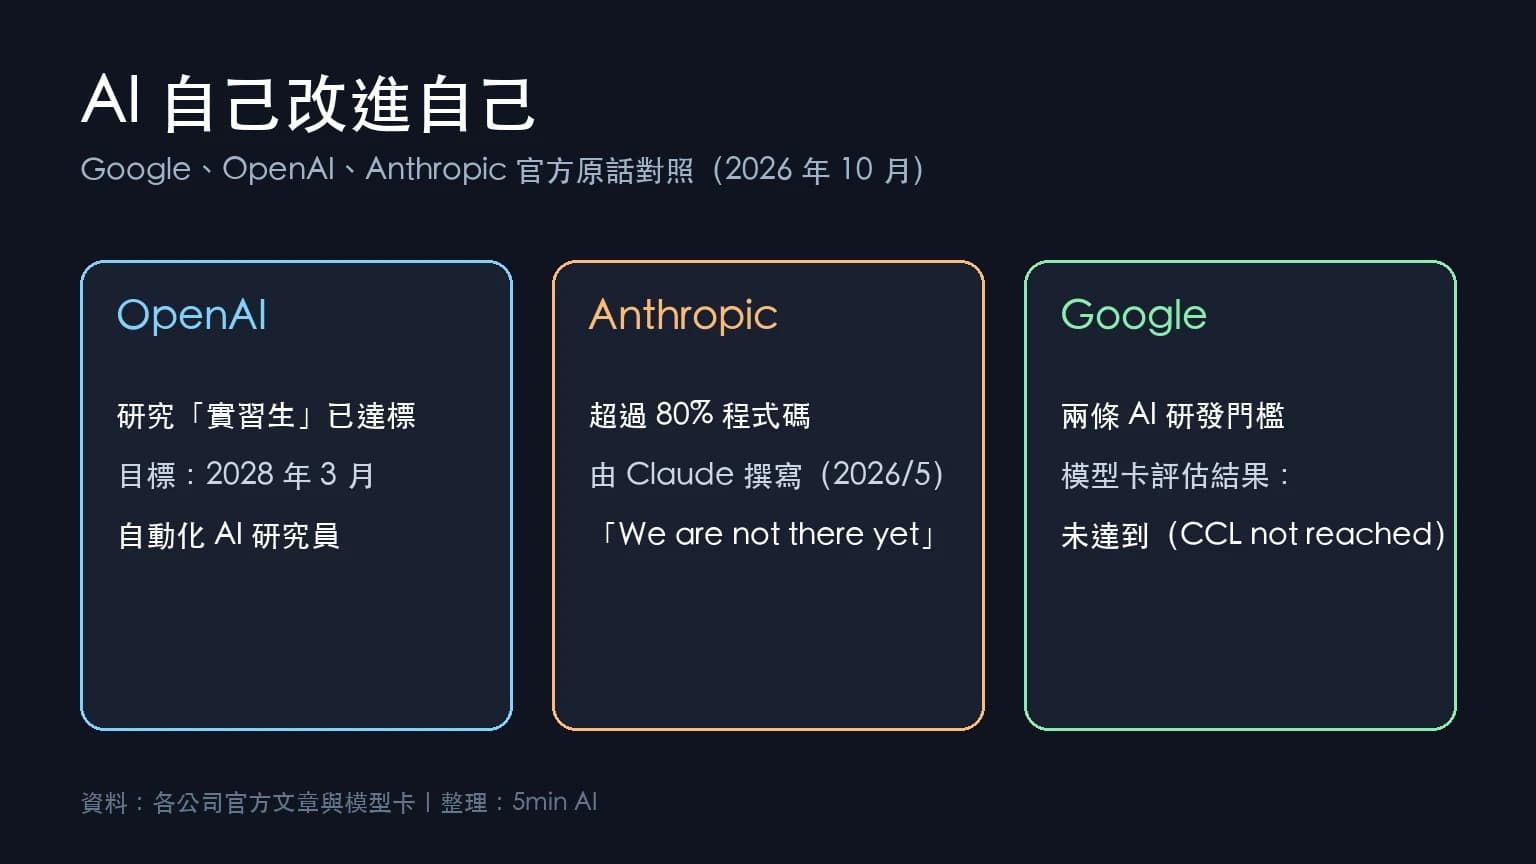
AI 自我改進 RSI
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南
Claude Prompt Caching
Claude API Prompt Caching 教學:大幅降低 Anthropic API 費用
解析 Claude Prompt Caching 的運作方式與計價:自動快取與手動斷點、5 分鐘與 1 小時快取、最小快取長度與 usage 欄位,附 Claude Sonnet 5.5 費用試算,幫開發者降低 Anthropic API 費用。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。