研究突破
MedRealMM:中文線上醫療諮詢的真實世界多模態基準測試
MedRealMM: A Real-World Multimodal Benchmark for Chinese Online Medical Consultation

arXiv cs.AI · 2026-07-13
摘要
研究團隊推出 MedRealMM,一個基於中國網路醫院真實患者-醫生互動數據構建的大規模多模態基準測試。該基準透過臨床挑戰點提取框架識別真實諮詢過程中的關鍵時刻,並納入患者上傳的醫療影像,採用醫師精調的評分標準評估 LLM 的臨床回應品質,相比現有依賴合成數據或多選題評測的方法更貼近實際臨床需求。
研究團隊推出 MedRealMM,這是一個基於全國性中國網路醫院去識別化患者與醫生互動數據構建的大規模多模態基準測試。該研究針對大型語言模型(LLMs)在線上醫療諮詢中日益廣泛的部署,指出現有基準測試與真實臨床實踐嚴重脫節的問題。
現有方法多依賴合成對話或患者模擬器,且往往遺漏患者上傳的醫療影像。此外,它們使用多選題或詞彙重疊指標來評估開放式臨床回應,這些指標無法真實反映臨床品質。MedRealMM 透過 Multimodal Clinical Challenge Point (MCCP) 提取框架,識別真實諮詢軌跡中的臨床挑戰時刻,並將每個時刻轉換為標準化的下一步回應生成任務,同時保留前文的文字與影像情境。
每個數據實例都配有一個由醫師精調的特定案例評分標準(case-specific rubric refined by physicians),用以評估大型語言模型的臨床回應品質。此方法旨在解決現有基準測試在數據來源、多模態內容及評估指標上的不足,提供更貼近實際臨床需求的評估方式。
●開發者:可用於評估和優化醫療 LLM 的多模態能力
●投資人:線上醫療 AI 應用的評估工具助力商業化
●一般用戶:未來線上醫療諮詢服務的品質評估更加科學可靠
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →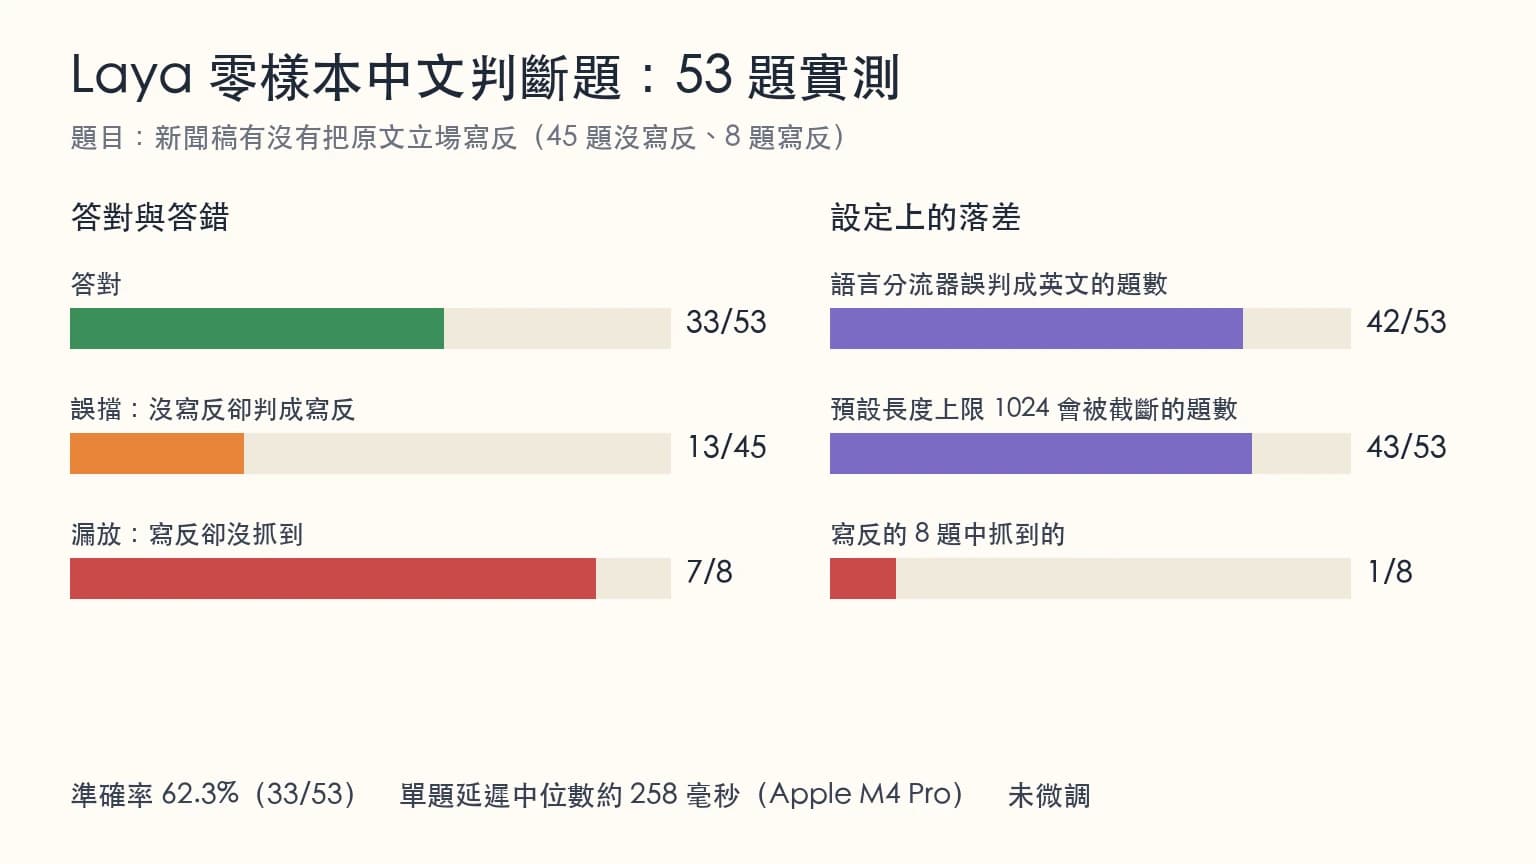
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。