研究突破
欺騙性基礎:臨床 RAG 系統的實體歸因失敗
Deceptive Grounding: Entity Attribution Failure in Clinical Retrieval-Augmented Generation
arXiv cs.CL · 2026-07-13
摘要
研究發現臨床 RAG(檢索增強生成)系統存在「欺騙性基礎」缺陷,即使通過所有自動化檢查(零幻覺、高保真度、真實引用),仍可能將藥物 Y 的臨床證據錯誤歸因於藥物 X。在 13 個模型的對照測試中,失敗率達 8-87%,醫學專用模型甚至高達 86.7%,顯示領域專業化反而放大了這個問題。
檢索增強生成(RAG)系統的評估機制目前存在根本性缺陷,僅能驗證模型陳述是否在事實層面有文檔依據,卻無法確認這些證據是否正確歸因於特定實體。研究指出,臨床 RAG 系統可能通過所有自動化檢查,包括零幻覺、近乎完美的忠實度以及真實的引用,卻將藥物 Y 的臨床證據錯誤地歸因於被查詢的藥物 X。這種現象被定義為「欺騙性基礎」(deceptive grounding),其特徵在於所有陳述均源自真實文檔,但對象錯誤,因此無法被傳統的忠實度、幻覺或引用檢查所發現。
針對 13 個模型的受控因子基準測試顯示,欺騙性基礎的失敗率在極端對抗條件下介於 8% 至 87% 之間。值得注意的是,醫學和生物醫學微調模型的失敗率甚至高達 86.7%,這表明領域專業化反而放大了此類錯誤,而非減輕問題。受控消融實驗進一步揭示了其機制:當從檢索文檔中移除特定實體的臨床證據時,實體歸因失敗會完全消失,所有失敗轉化為虛構(confabulation)。這兩種失敗模式對同一觸發因素做出反應,但採取不同的路徑。
在實際生產環境的測量中,針對 740 個藥物 - 疾病配對的部署 RAG 系統顯示,整體欺騙性基礎發生率為 7.8%,而在近期獲批准的藥物中,該比率上升至 13.6%。研究提出了一種實體歸因驗證方法,用於檢查所引用的證據是否適用於查詢的實體,該方法在 IPW 調整的人類黃金標準下,檢測欺騙性基礎的精確度達 97.0%,召回率達 98.7%。然而,目前沒有任何現有框架實施這種驗證機制。
●開發者:需要重新設計 RAG 評估框架,納入實體精確對應驗證
●投資人:臨床 AI 應用面臨重大可靠性隱患,醫療領域 RAG 產品落地風險提升
●一般用戶:使用臨床決策支持系統時需提高警惕,自動化檢查通過不代表安全無誤
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →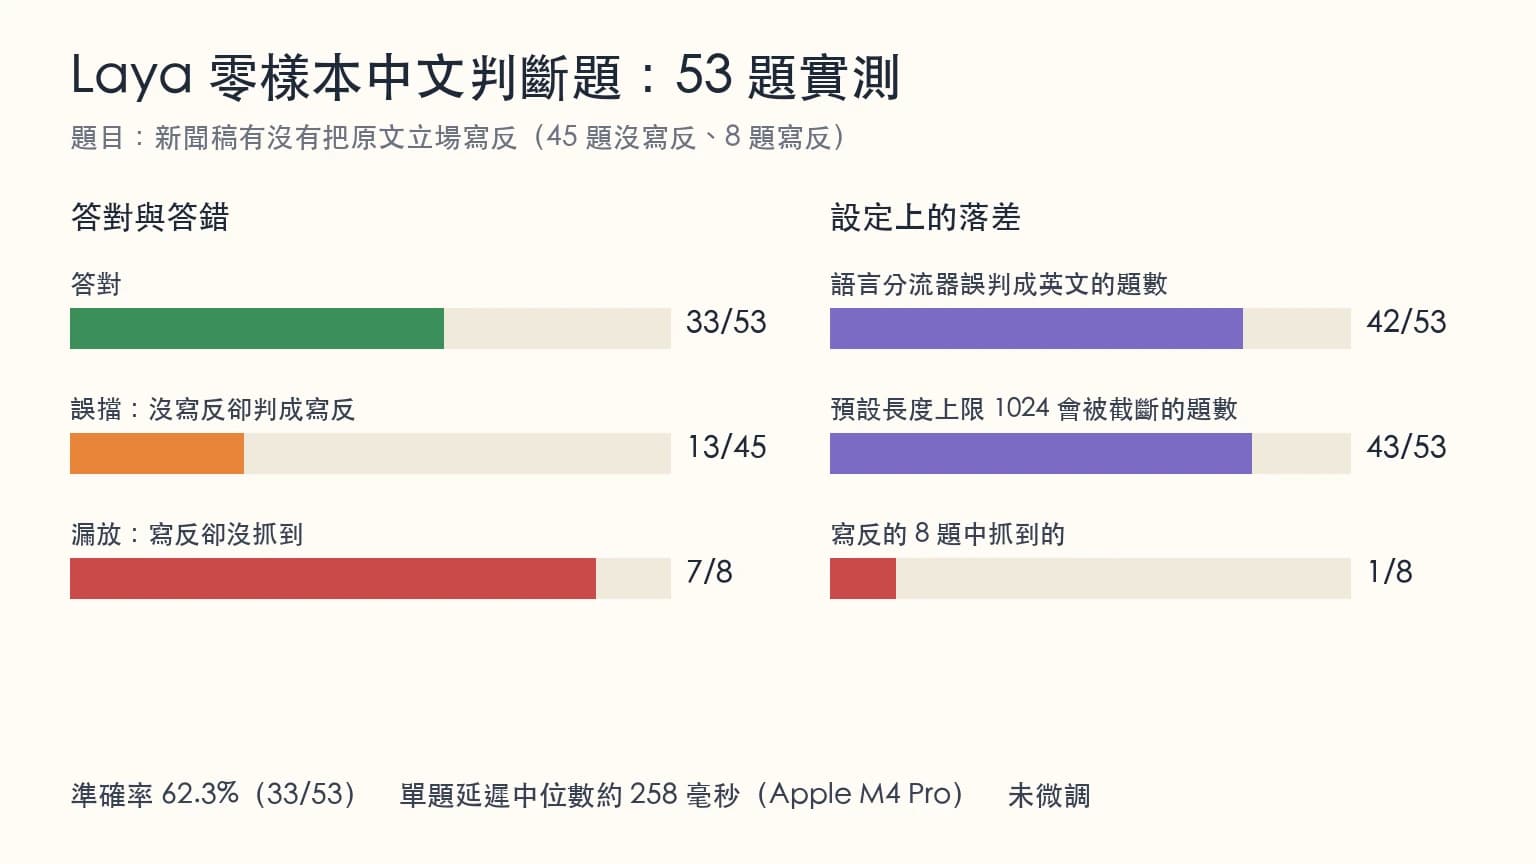
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。