安全倫理
忠實設計:評估和改進 LLM 生成的臨床試驗摘要
Faithful by Design: Evaluating and Improving LLM-Generated Clinical Trial Summaries for Multi-Stakeholder Audiences

arXiv cs.CL · 2026-07-14
摘要
研究團隊針對 LLM 在臨床試驗摘要中的幻覺問題,建立了評估架構來測量 GPT-4o、Claude Sonnet 4.6 和 Gemini 2.5 Flash 的忠實度。評估涵蓋 200 項臨床試驗和 1,800 份生成摘要,針對醫療提供者、患者和付款人三種受眾設計,發現「不受支持的聲明」是所有模型的主要失敗模式。這項研究對醫療 AI 應用至關重要,因為在臨床決策中的幻覺可能危害患者安全。
●開發者:需重視 LLM 在醫療領域的幻覺檢測和知識圖譜增強技術
●投資人:臨床 AI 可信度和安全性將成為醫療科技的投資重點
●一般用戶:未來臨床摘要服務將更可靠,患者能獲得更準確的試驗結果資訊
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →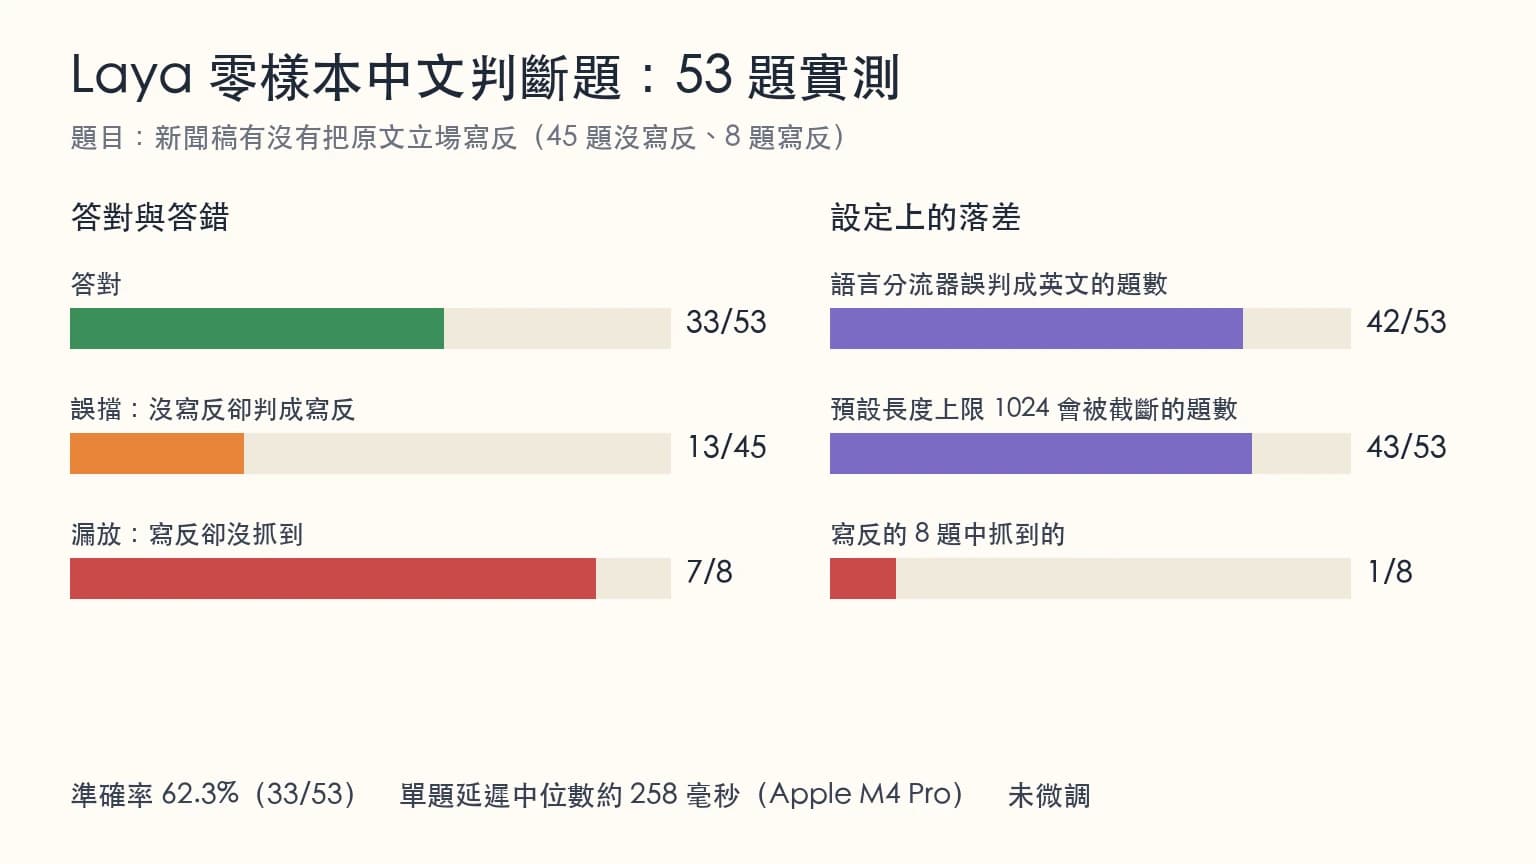
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。