研究突破
Zing:LLM 的社交智能框架
Zing: Social Mind for LLMs
arXiv cs.CL · 2026-07-28
摘要
研究團隊發佈 Zing 框架與 SoMBench 基準,用來測量和提升大語言模型的社交智能能力。該框架涵蓋心理學基礎的 71 個任務範式,評估顯示目前最強模型也只達 72% 準確率,說明 LLM 在理解人類心理狀態、社交關係和行為規範方面仍有大幅進步空間。這對推進 LLM 從單純任務求解向長期人機互動邁進至關重要。
研究團隊提出 Zing 框架與 SoMBench 基準,旨在應對大語言模型從孤立任務求解轉向長期人類環境服務時所需的社交智能,即推斷心理狀態、追蹤社交關係、基於規範推理及在情境中調整行為的能力。SoMBench 是一個基於心理學的基準,涵蓋 3 個主要維度、17 個次要維度及 71 個任務範式,在 284 個共享情境與 3,481 個專家驗證實例中控制問題格式、敘事視角與情境長度。
對 20 個代表性大語言模型的評估顯示,目前最佳模型的整體準確率僅為 72.08%,且 17 個次要維度中沒有任何一個達到 90% 的接近天花板區間,表明現有模型在社交智能方面仍有顯著提升空間。為解決此問題,團隊開發了 Zing,這是一種結合監督微調、線上策略蒸餾與基於評語的強化學習的診斷驅動訓練配方。
在性能表現上,Zing 在五個社交認知基準上持續優於其基礎模型,其中 Zing-27B-Stage2 取得最佳平均分數,而 Zing-32B-Stage2 則與 DeepSeek-V4-Pro 保持競爭力。針對部署時的接地(grounding),團隊構建了 Actio,這是一種受調度控制的推理架構,將四種類型的支持路由至推理過程:PRISM 用於程序指導,Starling 用於運行時心理狀態表示,SAGE 用於可重用經驗,以及閾控 RAG 用於外部社交與規範知識。
Actio 架構在五個基礎模型與三個基準的測試中,改善了 15 對模型 - 基準組合中的 14 對,並在 8 對中表現最佳或並列最佳,證明了類型化運行時支持的有效性。這些結果表明,具有社交智能的大語言模型需要評估、參數化內部化與部署時接地三方面的協調進步。
●開發者:可將 Zing 的訓練方法整合進 LLM 微調流程,改善模型社交推理能力
●投資人:社交智能是 LLM 商業化的關鍵門檻,相關技術具長期價值
●一般用戶:未來的 AI 助手將更理解人類需求和社交脈絡,互動體驗會更自然貼心
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南 →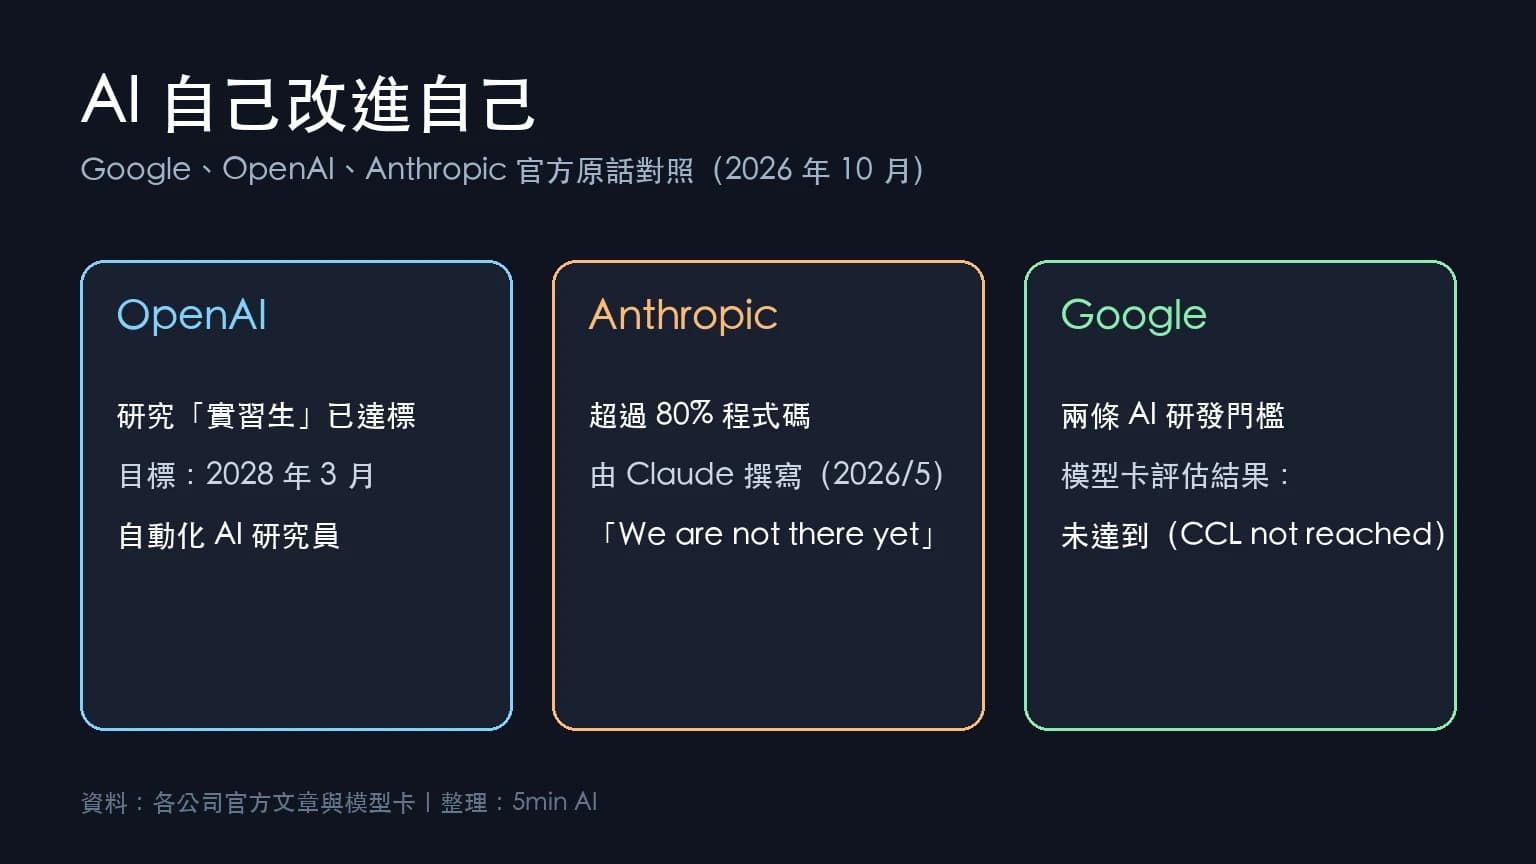
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →
Notion AI vs NotebookLM:AI 筆記與會議記錄工具比較
Notion AI vs NotebookLM 深度比較:分析兩款 AI 筆記軟體的會議記錄、知識管理與價格差異,協助你找到最適合的 AI 筆記軟體推薦。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。