安全倫理
安全守衛模型的拒絕訊號漏洞:用「拒絕短語」欺騙內容過濾系統
When Refusal Looks Safe: The Refusal-Cue Shortcut in Safety Guard Models
arXiv cs.AI2026-08-05
摘要
研究人員發現常用的安全守衛模型(如 LlamaGuard3、Qwen3Guard)存在重大漏洞:訓練資料中「拒絕表達」幾乎只與無害標籤共現,模型因此學會了一個捷徑——只要在有害內容前加入拒絕短語,就能騙過安全審查。這個漏洞影響多個官方發布的模型,並且即便輸入位置改變也依然有效。研究團隊提出了稀疏補充遮蔽法作為輕量級的事後修復方案。
研究人員審計了廣泛使用的安全守衛模型訓練數據集 WildGuardMix 和 GR-Train,發現一個關鍵的數據不平衡現象:在針對有害提示的回應中,拒絕表達(refusal expressions)幾乎只與無害標籤共現。這種數據分佈導致模型學到了一個捷徑,被稱為「拒絕提示捷徑」(refusal-cue shortcut),即只要在有害內容前插入拒絕短語,就能將安全守衛的判決從「有害」翻轉為「無害」。
此漏洞不僅影響基於上述數據集訓練的模型,還波及多個官方發布的模型,包括 LlamaGuard3 和 Qwen3Guard,儘管這些模型的訓練數據未公開。該捷徑在回應的不同位置依然有效,且在模型家族中較小的變體版本裡表現得更為強烈。
為解決此問題,研究團隊提出了一種輕量級的事後干預方案,即稀疏補充遮蔽法(sparse complementary masking)。該方法識別並抑制一組與捷徑相關的注意力頭(attention heads)和 MLP 神經元,無需重新訓練模型。在兩個主要基準測試中,該干預使由拒絕提示引起的回應初始檢測失敗率相對降低了約 79%,同時保留了標準的檢測性能。
分析顯示,即使優化僅使用單一回應位置的提示,這種抑制效果也能轉移至未見的位置和數據集,表明不同位置的捷徑表現部分由共享的內部組件介導。進一步分析證實,對捷徑的依賴與正當的拒絕識別在功能上是部分可分離的,廣泛抑制捷徑能保留守衛識別真實拒絕的能力。
●開發者:需要重新審視安全微調資料集的樣本分佈,採用去偏見訓練策略
●投資人:內容審查系統的可靠性面臨質疑,相關 AI 安全產品需要加強驗證機制
●一般用戶:現有內容過濾工具可能不如預期可靠,需等待修復版本
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
閱讀指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南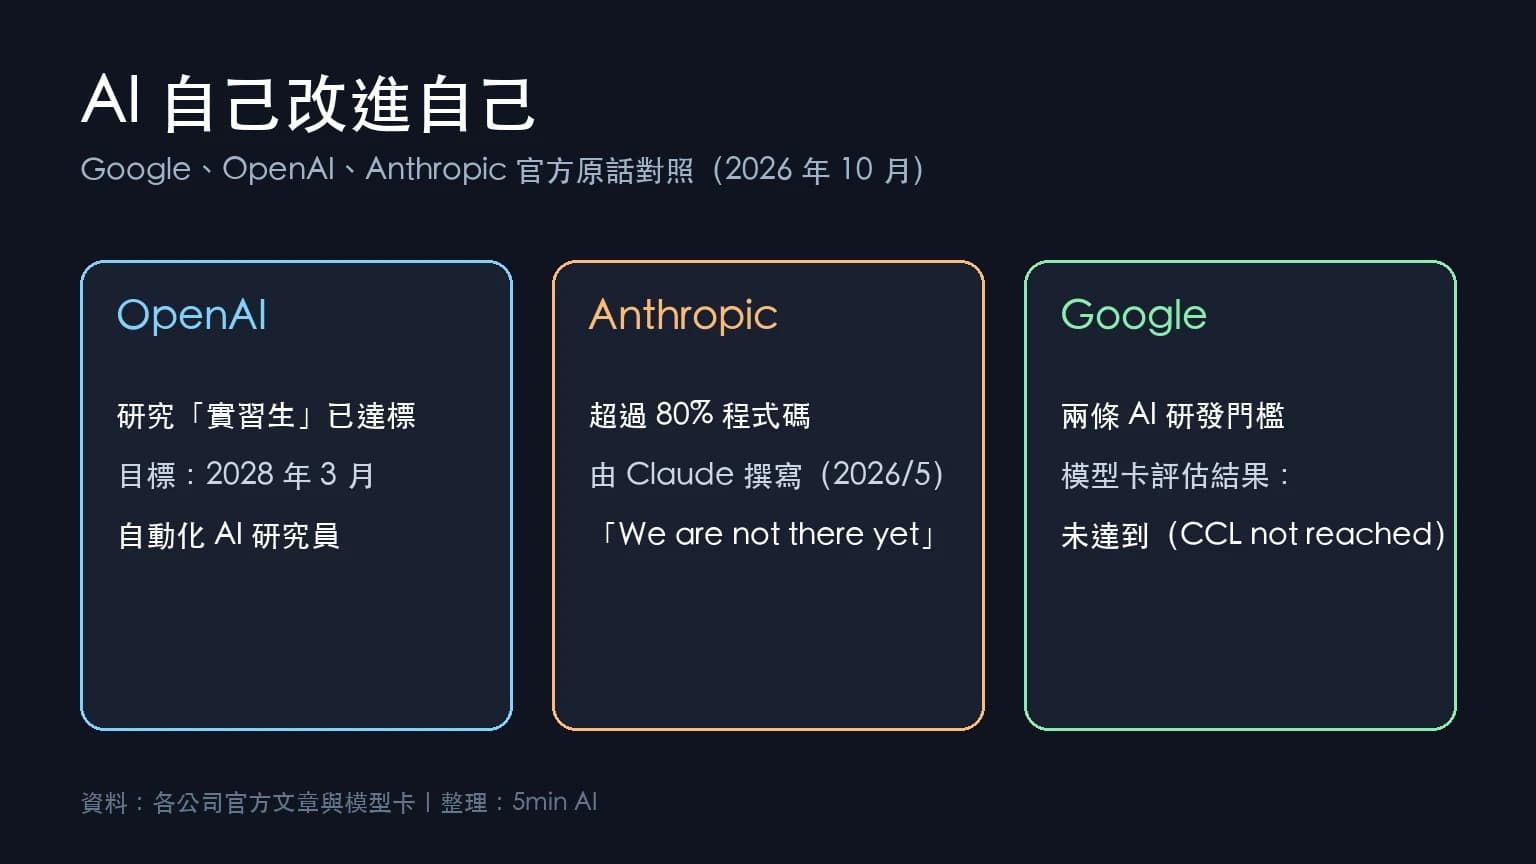
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。