研究突破
評估盲點:無聲測量失敗如何從訓練到部署腐蝕 AI 系統
Evaluation Blindness: How Silent Measurement Failures Corrupt AI Systems from Training to Deployment
arXiv cs.LG2026-08-05
摘要
研究指出 AI 系統存在「評估盲點」現象,測量函數在系統實際故障時仍顯示健康狀態,導致失敗無聲傳播。問題涵蓋訓練階段(獎勵模型遊戲化、重要性採樣計算誤差、基準汙染)和部署階段(生產監控無法捕捉六類故障),威脅系統可靠性和安全部署。
研究提出「評估盲點」(evaluation blindness)概念,指測量函數 M 在系統實際處於失敗狀態時,產出與健康狀態無異的讀數,且無任何輔助信號標示差距。這種無聲失敗會透過訓練迴圈、評估管線及生產監控堆疊傳播,直到下游造成實質傷害才顯現。問題涵蓋生命週期的兩個階段:訓練階段與部署階段,文獻以往將兩者分開處理。
在訓練階段,獎勵模型被操弄、重要性採樣修正被無聲誤算,且基準汙染會膨脹微調評估結果,儘管損失曲線看似健康且梯度更新正常進行。研究包含四個訓練時期的案例研究,追蹤具體崩壞,其中包括 TRL PR #6594 的真實實現錯誤,顯示在損失正常下降時梯度已遭腐蝕。
在部署階段,監控無法捕捉六類生產失敗,其中「運作類別」(Operational category)在結構定義上為 100% 無聲。研究提出一個統一的正式可偵測性判別式,並建立六類分類法,該分類法針對 50 起來自法庭文件與監管申報的真實世界事件進行驗證,發現 53% 的可驗證公開失敗屬於無聲狀態。研究同時提出失敗預算框架,將可接受的失敗率與使用案例風險類別掛鉤。結論指出,測量基礎設施是整個 AI 生命週期的正確性問題,而不僅限於評估時間。
●開發者:需重新審視評估指標設計和監控策略,建立多層次故障檢測機制
●投資人:AI 系統品質和可靠性問題將影響產品上線周期和運營成本
●一般用戶:使用的 AI 應用可能存在隱性故障風險,需要更嚴格的部署標準
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
閱讀指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南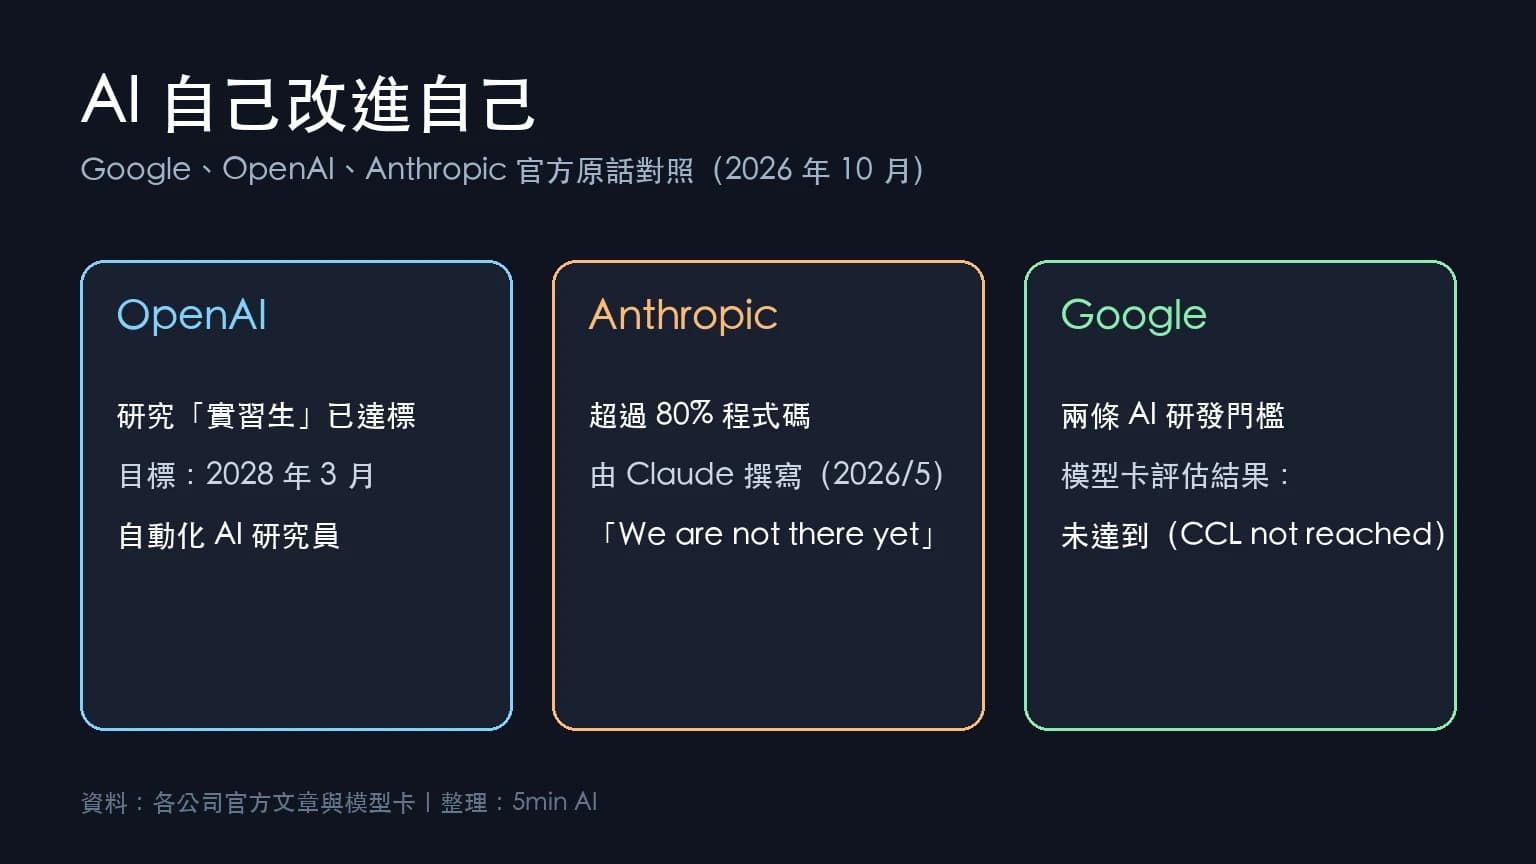
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。