垂直產業
FormBharo:為印度農村設計的語音對話填表系統
FormBharo: Designing and Evaluating a Voice Agent for Conversational Form Filling in Rural India
arXiv cs.CL · 2026-08-08
摘要
研究團隊開發了 FormBharo,一套由 LLM 結合規則型驗證系統組成的語音智能體,能透過電話通話幫助識字率低的印度母親填寫社會福利表單。這套系統正與印度 NGO ARMMAN 合作試點,專門為低收入、使用印地語的母親提供產前和產後護理登記服務,同時開源了包含 3,760 個多轉向對話的 FormVoiceAgentBench 基準資料集。
在印度,幾乎所有社會福利的申請都始於填表,但最需要這些福利的人群往往缺乏读写能力。目前這項工作依賴前線健康工作者逐一為受益人登記,這種方式對有限的資源而言效率極低。研究團隊開發了 FormBharo(印地語意為「填表」),這是一套語音智能體,旨在透過電話通話在嚴格的延遲和成本預算下,結合大型語言模型(LLMs)與確定性規則驗證及流程控制,來填寫結構化表單。
該系統目前正與印度非政府組織 ARMMAN 進行試點合作,ARMMAN 在印度運營大規模的母嬰移動健康項目。FormBharo 專門針對低收入、使用印地語的母親,協助她們完成產前和產後護理的登記。據研究團隊表示,這是首個針對該人群進行登記表單填寫試點的語音智能體。
為了評估系統效能,研究團隊開源了 FormVoiceAgentBench 基準資料集,該資料集包含人類錄製的印地語語音,以及涵蓋 960 個模擬通話的 3,760 個多轉向對話測試,用於評估語音轉寫、資訊提取、回覆生成及端到端表單填寫的表現。研究發現,當 LLMs 接收包含錯誤的真實語音轉寫而非參考轉寫時,表單填寫率會下降高達約 41 分。
研究數據顯示,確定性規則控制能恢復許多單輪次的提取錯誤,幫助較小、較便宜的模型在表單填寫上匹配甚至超越前沿模型。此外,組件效能並不預測端到端效能:GPT-5.5 在參考轉寫上的單輪提取準確率達到 99.8%,但在表單填寫的排名卻較低。由於錯誤在整個流程中既會傳播也會相互抵消,最佳模型選擇必須透過端到端評估才能確立。
由於沒有任何單一模型能同時在準確性、成本和延遲上表現最佳,研究團隊採用基於帕累托的加權總和標量化方法,選擇了一個平衡這三項指標的部署配置。這表明在真實的語音變異環境下,單純依賴單一組件的優異表現無法保證最終的表單填寫成功。
●開發者:可學習 LLM 結合規則系統在資源受限環境下的實踐方式,以及多語言語音處理最佳實踐
●投資人:醫療健康領域的 AI 應用、新興市場普惠金融科技值得關注
●一般用戶:識字困難人群將能更便利地申請社會福利服務
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
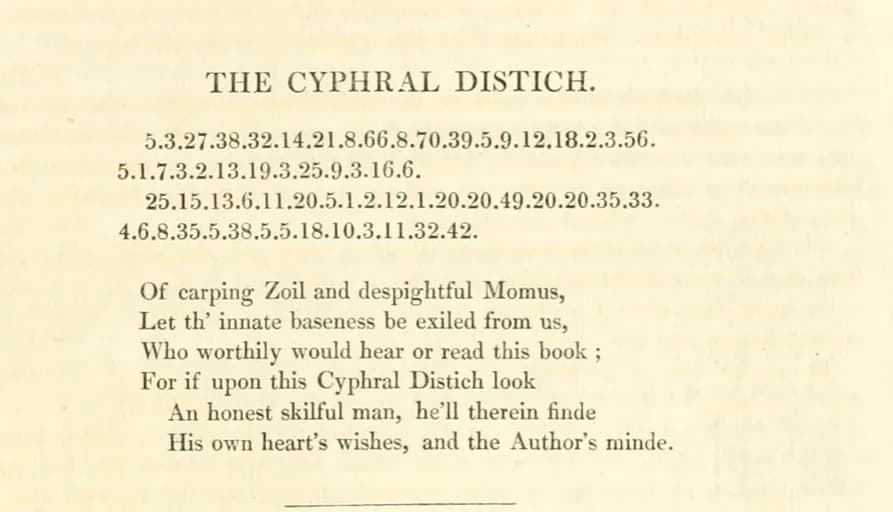
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →
TypeSafe Jev 實際上手:三個真實情境,看「只做判斷的 AI」能替你省掉哪些 if
拿到帳號後,我們用日報管線的真實資料把 TypeSafe Jev 跑了一輪:新聞分類、社群選題、讀者來信路由,外加幾個它做不到的邊界測試。附每一題的實際機率、422 拒絕原文,以及三個必須自己補的坑。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。