研究突破
RAG 系統三重魯棒性分析:GraphRAG 引用精確度與忠實度的架構與語料依賴
Universal Pathologies, Conditional Consequences: A Triple-Robustness Analysis of RAG for Multi-Hop Traceability

arXiv cs.CL · 2026-08-08
摘要
一項針對 RAG 系統的大規模分析顯示,GraphRAG 在引用精確度上普遍低於向量 RAG,且存在架構性的過度引用問題。研究指出,GraphRAG 的忠實度表現高度依賴語料庫類型:在結構化需求文件中忠實度大幅下降,但在維基百科等自然語料中則能維持較高水平。這揭示了 RAG 系統在跨領域應用時,其可靠性並非絕對,而是與底層數據結構密切相關。
一項針對 RAG 系統的大規模分析研究(arXiv:2608.05153v1)揭示了 GraphRAG 在引用精確度上普遍低於向量 RAG 的現象,並指出其過度引用問題具有架構上的普遍性。研究團隊在固定檢索架構的前提下,對嵌入模型(從 local e5-small 變更為 Azure text-embedding-3-small)、語料庫(從 DO-178C 類型邊界需求文件變更為 Wikipedia 段落鏈)以及評判模型(配對使用 GPT-5.4 與 GPT-4.1)進行了三軸正交變換,共執行 4,440 次主矩陣運行、600 次跨語料庫運行及 1,200 次配對忠實度評判。
數據顯示,GraphRAG 在所有三種設定下均存在架構性的過度引用問題,平均每個答案會輸出 11 至 15 個 ID,其引用精確度介於 0.12 至 0.23 之間,檢索召回率則介於 0.68 至 0.87 之間。這種過度引用直接導致了忠實度表現的語料依賴性:在結構化的 DO-178C 類型邊界需求文件中,GraphRAG 的忠實度在跨跳躍(hops)過程中從 74% 暴跌至 40%;然而,在 Wikipedia 段落鏈的設定下,同一管線卻能從 42% 提升至 58%,因為過度引用的段落仍能保持主題上的支持性。
●開發者:在選擇 GraphRAG 或向量 RAG 時需評估數據結構對忠實度的影響
●投資人:RAG 基礎設施的可靠性差異可能影響企業級應用落地
●一般用戶:AI 回答的準確性可能因來源資料類型而異
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

RAG 是什麼?白話文解釋 AI 如何結合搜尋與生成(附實例)
RAG(檢索增強生成)是什麼?用白話文解釋:AI 先去查資料、再根據查到的東西回答,讓答案更準確。本文附實際運作流程圖與實際應用案例,5 分鐘看懂。
閱讀指南 →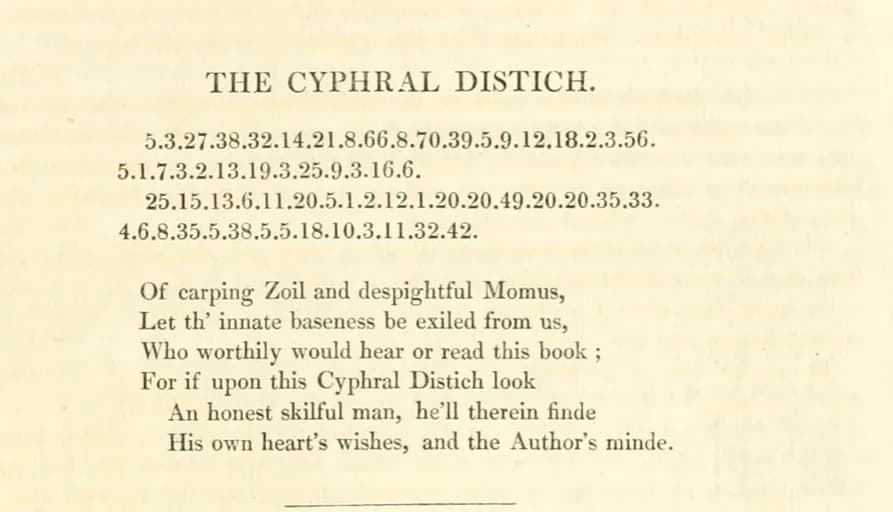
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。