研究突破
AI 聊天機器人能找到專家級的醫學文獻嗎?模型、用戶身份和樣本量的影響研究
Do AI chatbots find what experts would? Effects of model, user role, and sample size on study retrieval for medical questions

arXiv cs.CL · 2026-08-17
摘要
研究團隊測試了 Claude Sonnet 5、Gemini 3.1 Pro 和 ChatGPT GPT-5.5 三款 LLM 聊天機器人在回答臨床問題時的文獻檢索能力。結果表明,這些模型在引用醫學研究時存在顯著差異,不同用戶身份(患者、臨床醫生、研究人員)會影響檢索品質,這對醫療 AI 應用的可靠性提出重要警示。
●開發者:需關注 LLM 在醫療應用中的幻覺問題和引用準確性改進方案
●投資人:醫療 AI 領域需更嚴格的驗證標準,相關公司面臨信譽風險
●一般用戶:目前不應完全信賴 AI 聊天機器人的醫療建議和文獻引用
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →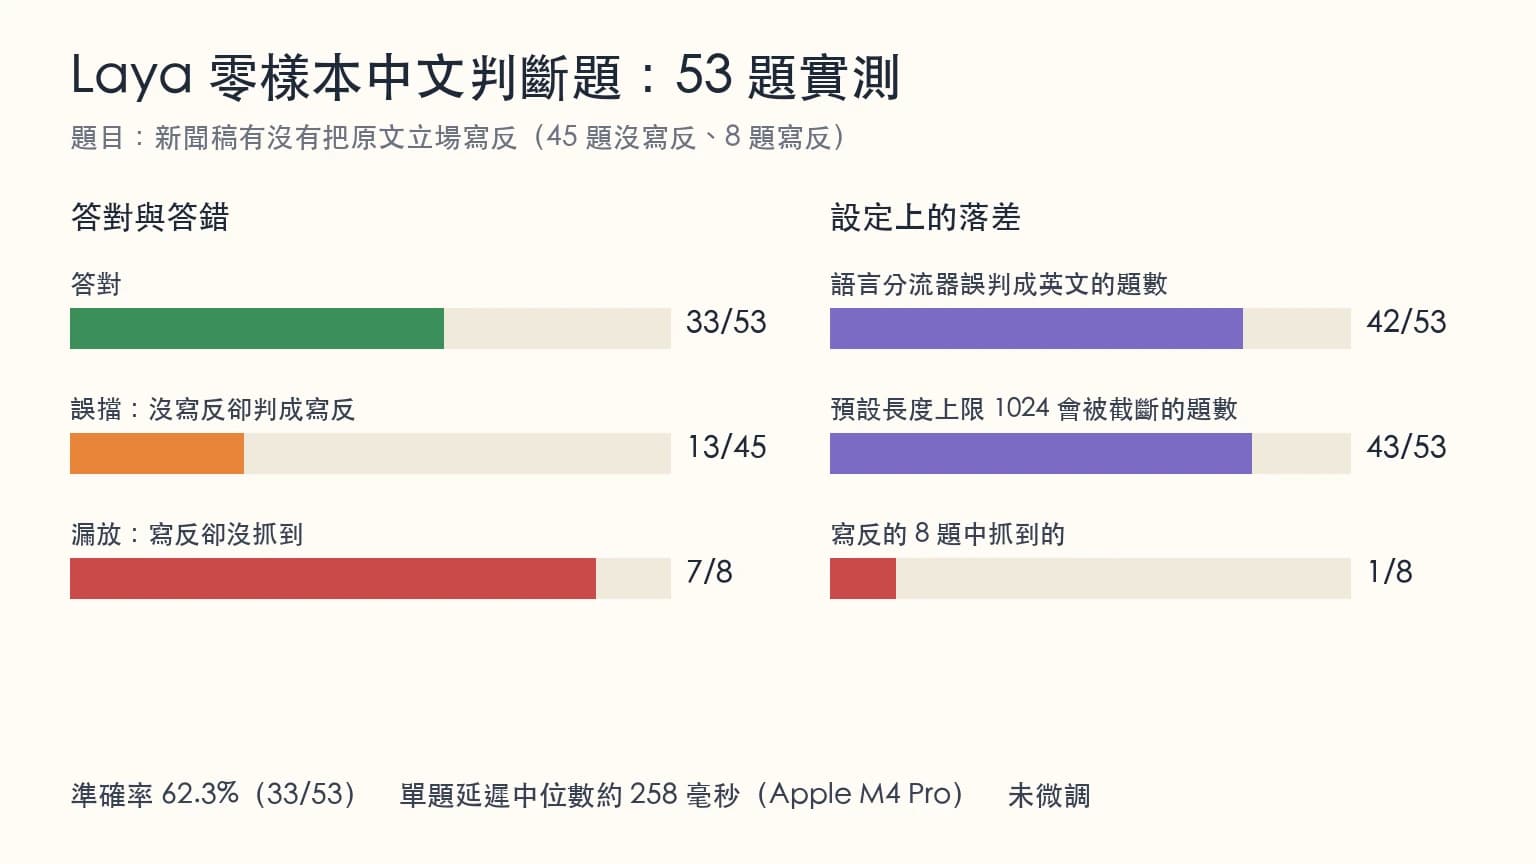
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →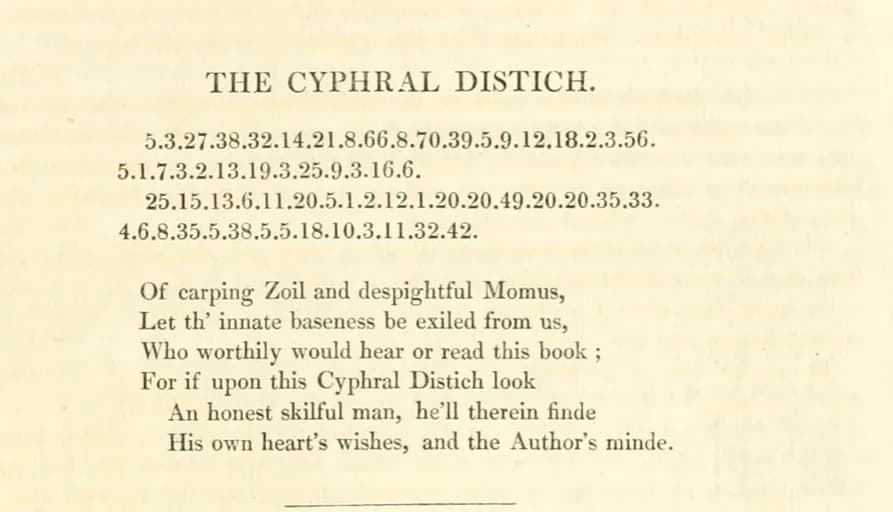
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。