研究突破
frontier LLM 在腫瘤決策中的集體能力邊界:ODBB 基準測試發現 42% 的決策點存在共同盲點
A collective capability boundary in frontier large language models on guideline-conformant and case-specific oncology decision-making
arXiv cs.AI · 2026-09-01
摘要
研究團隊開發了腫瘤決策邊界基準(ODBB),涵蓋 2,005 個 NCCN 指南和結腸直腸癌臨床決策點,評估了 9 個 frontier LLM(包括 4 個閉源、5 個開源模型)的實際臨床決策能力。結果顯示,即使是最強的 LLM 集合,仍有 42.1% 的決策點存在失敗,且這些失敗涉及 14 種系統性問題類型,揭示了現有大語言模型在醫療決策中的共同認知邊界。
●開發者:需重新評估 LLM 在醫療實務應用的可靠性邊界,應聚焦決策路徑推理而非單純知識檢索
●投資人:LLM 在醫療診療輔助的商業化存在系統性風險,應謹慎評估相關應用融資
●一般用戶:現階段不應過度依賴 LLM 作為腫瘤診療決策的主要參考,需結合專業醫生判斷
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
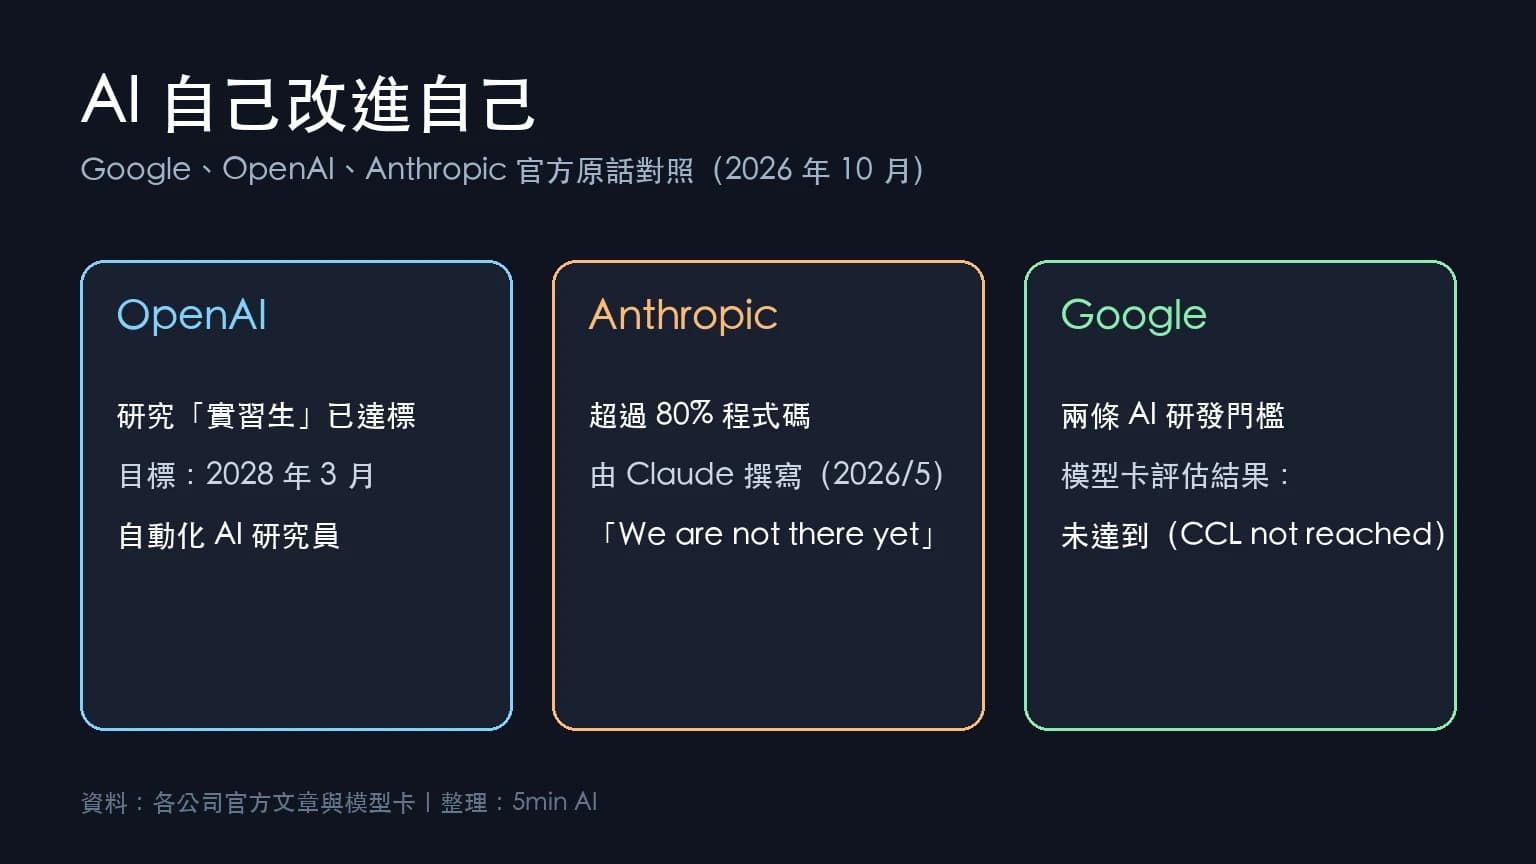
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →
Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。