安全倫理
Black-Box Red Teaming of Agentic AI:自動化風險發現的分類法框架
Black-Box Red Teaming of Agentic AI: A Taxonomy-Driven Framework for Automated Risk Discovery

arXiv cs.AI · 2026-09-11
摘要
研究團隊提出一套黑盒紅隊測試框架,專門評估 Agent AI 系統的安全風險。框架包含七大風險領域分類、自動化對抗場景生成與 LLM 評判,在 CrewAI 和 AutoGen 等主流 Agent 架構上測試發現,治理風險平均達 56.25%、隱私風險高達 65%、行為漏洞更突破 85%。這項研究揭露了當前多步驟自主 Agent 的嚴重安全缺陷,對於推進生產環境中的 Agent 部署具有重要預警意義。
●開發者:需重視 Agent 系統的安全評估與多步驟漏洞修補
●投資人:Agent 生產部署的風險管理成為新的競爭壁壘
●一般用戶:自主 Agent 廣泛應用前應加強隱私與安全防護
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
LLM 模型安全與倫理實戰:2026 年企業合規與風險管理指南
2026 年企業如何確保 LLM 模型安全?本指南涵蓋 AI 倫理規範、企業 AI 合規策略及模型紅隊測試實戰步驟,協助建立安全的 AI 部署環境。
閱讀指南 →
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南 →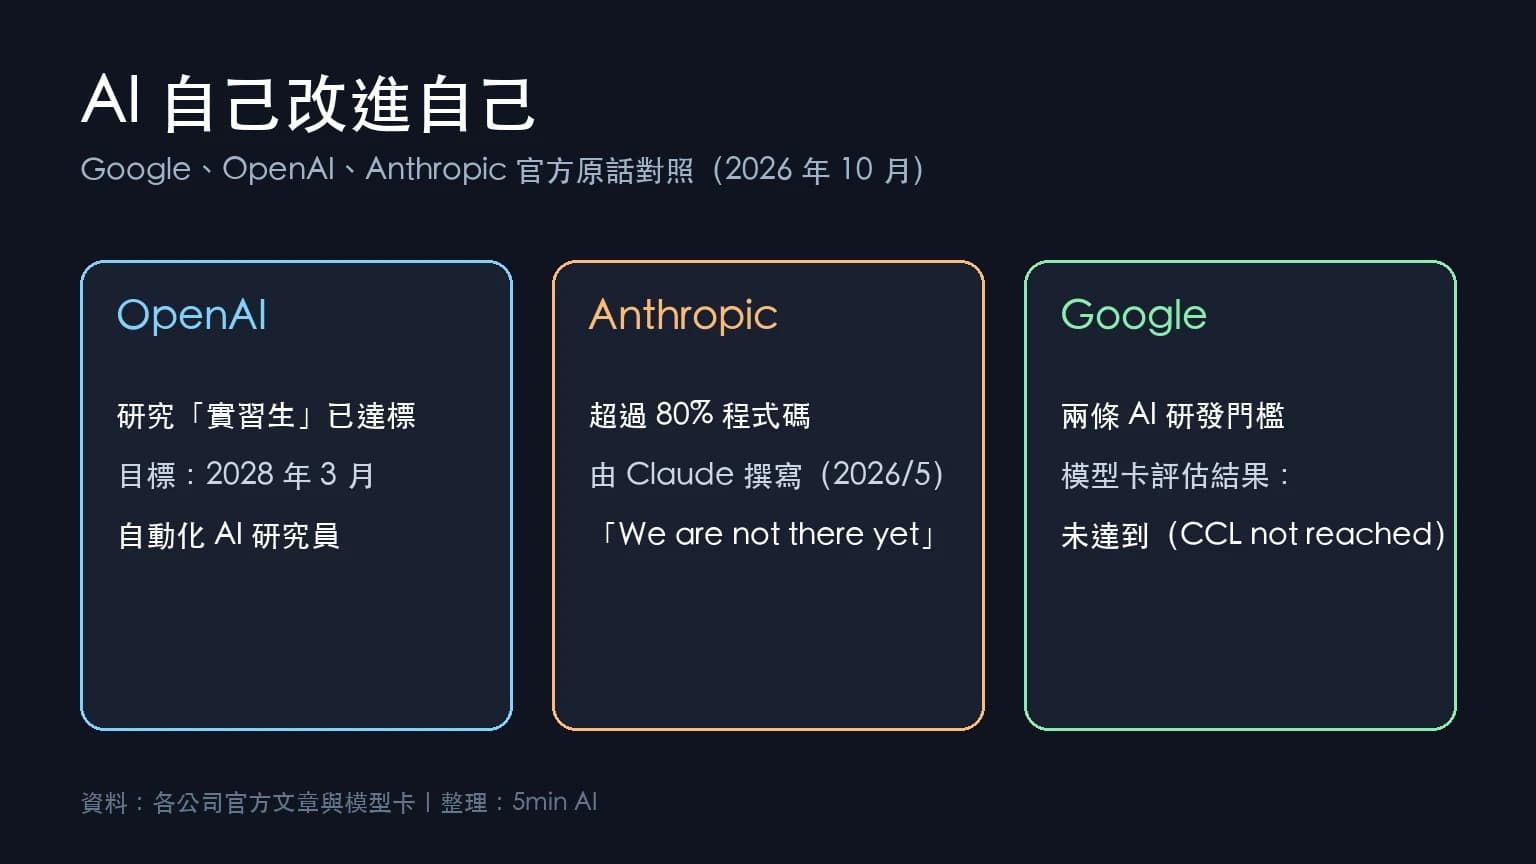
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。