垂直產業
LLMs 能否遵循醫學專家邏輯?LogiMed-RoB 基準測試揭示 AI 推理的層級一致性危機
Can LLMs Follow Medical Expert Logic? A Benchmark for Hierarchical Logical Consistency in Risk-of-Bias Assessment
arXiv cs.AI · 2026-09-12
摘要
研究團隊推出 LogiMed-RoB 基準,用 860 份隨機對照試驗和 14,820 個查詢來評估 LLMs 在醫學證據推理中的邏輯一致性。實驗發現一個嚴重問題:即使頂級模型在原子層級達到 98.88% 的一致性,端到端推理準確率卻急劇下降至 45.13%,部分開源模型甚至接近零。這揭露了 AI 在複雜醫學決策中存在的系統性推理缺陷,對臨床應用的安全性構成重大威脅。
研究團隊推出 LogiMed-RoB 基準,用以評估大語言模型在醫學證據推理中的邏輯一致性。該基準以 Cochrane Risk of Bias (RoB) 2.0 專家邏輯為基礎,包含 860 份隨機對照試驗和 14,820 個查詢。
評估框架採用層級邏輯一致性(Hierarchical Logical Consistency, HLC)架構,涵蓋四個維度:原子層級一致性(Atomic Consistency)、領域一致性(Domain Consistency)、聚合一致性(Aggregation Consistency)及證據忠實度(Evidential Faithfulness)。
對 10 個最先進的 LLMs 進行實驗後發現錯誤複合效應(Error Compounding Effect)。頂級模型在原子層級一致性達到 98.88%,但端到端一致性急劇下降至 45.13%,多個開源模型甚至接近 0%。
研究還揭示系統性的證據推理差距:即使模型檢索到高質量證據,仍在推導正確結論時失敗,失敗率達 18.63% 以上。
●開發者:需要重新思考 LLMs 在關鍵決策任務中的架構設計,尤其是多步驟邏輯推導的可靠性
●投資人:醫療 AI 領域的商業化存在更大技術障礙,模型端到端表現遠低於預期
●一般用戶:使用 AI 輔助醫療決策時應保持高度謹慎,AI 的推理能力遠未達臨床應用標準
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南 →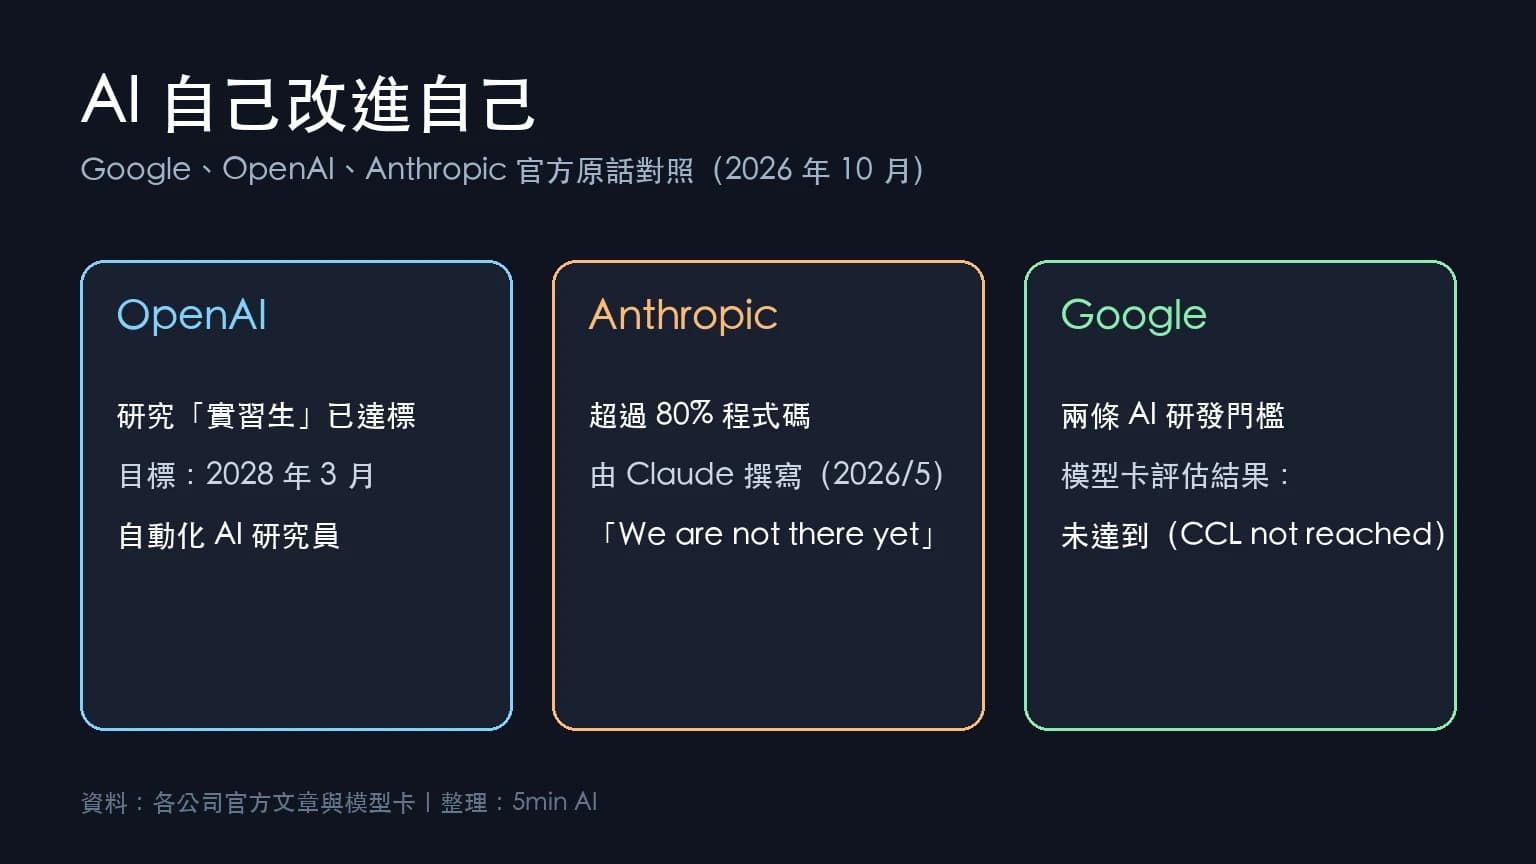
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →
Notion AI vs NotebookLM:AI 筆記與會議記錄工具比較
Notion AI vs NotebookLM 深度比較:分析兩款 AI 筆記軟體的會議記錄、知識管理與價格差異,協助你找到最適合的 AI 筆記軟體推薦。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。