開發工具
透過 Session 感知負載平衡來擴展實時 AI 代理
Scaling real-time AI agents with session-aware load balancing
developers.googleblog.com · 2026-09-20
摘要
Google 提出了針對實時 AI 代理的負載平衡方案,核心問題是長連接、有狀態的雙向流傳輸打破了傳統請求-回應模式,使伺服器容量測量失准。解決方案是在運行時實現應用層級的 Session 追蹤,將精確的會話計數與 CPU 利用率結合,透過混合路由演算法有效分配有狀態 AI 流量,防止單點瓶頸。
即時 AI 代理的基礎架構需求,跟傳統網路 API 差很多。一般 API 走的是熟悉的生命週期:用戶端發送請求、伺服器處理、回傳結果,連接就結束了。這種短生命週期模型好追蹤,用延遲、每秒查詢數(QPS)、CPU 使用率這些指標就能評估效能。
即時 AI 系統打破了這套模式。後端處理的不再是孤立的單一請求,而是要管理一條持續、雙向流動的連接。音訊段落、文字記錄、模型輸出、合成語音同時在兩個方向流通。用戶打斷對話時,伺服器得立刻暫停正在生成的語音、更新上下文、可能觸發新的工具調用,然後開始起草不同的回應——整個過程連接不能斷。這些特性逼著基礎設施得從頭想過,從最佳化單一請求,轉向管理活躍對話的複雜度。
傳統負載平衡指標行不通
傳統負載平衡策略通常優先看請求吞吐量和當下的 CPU 使用率。這些方法假設每個進來的請求會消耗可預測的資源量,任務完成就會釋放容量。但對長期、有狀態的 AI 串流來說,這些假設完全站不住腳。
比較兩項後端任務:任務 A 處理 100 個短請求,每個 50 毫秒;任務 B 只接 5 個請求,但每個都演變成 20 分鐘的會話。若只看請求到達率,任務 B 看起來負荷較輕,實際上扛的工作量更重、更持久。
QPS 追蹤的是到達量,抓不到伺服器已經在管理多少活躍對話。 CPU 使用率同樣會誤導人。以語音運行時為例,它可能同時維持 20 個靜默會話;因為沒有主動處理語音或跑模型推論,伺服器看起來沒吃滿。但這 20 個用戶一旦同時開口說話,CPU 使用率會瞬間飆高。
CPU 指標反映的是當下的處理負荷,活躍會話計數揭示的則是後端已經承諾要處理的工作量。做即時 AI,這兩種信號都得顧到。
串流應用層級負載的難題
即時代理通常靠雙向串流協議運作,像是 gRPC 或 WebSocket。實作方式不同,但都碰到同樣的基礎架構障礙:得維持開放、長時間運行的連接,資料兩個方向持續流動。
從網路層看,這只是一條簡單的連接;但在應用層,它其實是複雜的有狀態會話。單一即時代理會話裡可能有音訊緩衝區、部分文字記錄、正在執行的工具呼叫、模型上下文、用戶專屬指標,全都留在運行時記憶體裡。
標準負載平衡器搞不定這種情況。它們看到的是串流,但分不出哪個是真正活躍的用戶對話、哪個是閒置的聽眾,哪個又是重試或健康檢查這類背景雜訊。因為基礎架構看不到這些內部狀態,光靠通用連接指標不夠,得要應用層級主動回報。後端服務本身才是唯一有足夠上下文、能精確追蹤會話何時真正活躍、失敗、完成或被取消的環節。
在運行時追蹤活躍會話
一個簡單做法是在串流會話開始和結束時追蹤活躍會話數。範例程式碼展示了用遞增/遞減計數器來管理會話的基本方式,其中 `finally` 區塊確保計數器準確——這對路由決策非常關鍵。
計數器如果沒遞減,後端可能在會話結束很久之後看起來還是過載。反過來,重複遞減又會回報出不存在的容量,引來過多流量。實際上線的實作還得小心處理逾時、取消、斷線同時發生時的邊界狀況。說白了,幽靈會話帶來的不只是記憶體洩漏,更是誤導路由的假信號。
就算計數器準確,還得考慮同步問題。因為負載平衡器通常是按間隔去拉指標,而會話本身持續在啟動、結束,服務端得回報一致的活躍會話快照,避免負載平衡器根據過期資料做決策。
混合信號估算容量
有了活躍會話回報,負載平衡模型才能更貼近實際工作量。簡單的容量模型可能只用靜態插槽算:剩餘容量等於最大會話數減去活躍會話數。但這種演算法很脆弱,它假設每個會話的 CPU 成本都一樣,而生成式 AI 幾乎不會是這樣。
活躍會話計數不該取代基於利用率的平衡,而是要融合成混合模型。 利用率(CPU/記憶體)反映的是當下的資源壓力,會話計數反映的是已經承諾的未來負荷。
結合這兩種信號的一種方式,是透過回饋迴圈估算每個後端的有效容量。首先得把兩個信號換算成同一種測量單位。因為負載平衡器基本上是用速率在思考,所以要把靜態的會話計數轉成連續流的概念。舉例來說,如果後端在 10 秒的回報窗口內維持 90 個活躍會話,可以把它看作是 9 個「虛擬 QPS」。把靜態會話轉成標準速率之後,路由層就能把會話壓力無縫加進 QPS 這類傳統信號裡。
估算有效容量的簡化做法,是問:這個後端在達到目標利用率之前,還能再接多少工作?一個簡化的容量估算公式會考慮:目標利用率(例如 80% CPU)、平均利用率(例如過去 10 秒平滑後的 CPU 消耗)、每會話成本(最後一個回報窗口中活躍串流動態算出的平均 CPU 成本),以及安全係數(例如 2.0 的緩衝乘數)。
因為 CPU 利用率通常跟併發串流數呈非線性關係,安全係數扮演的是懲罰因子的角色,防止負載平衡器一口氣把太多新會話塞給看起來很閒的後端。負載平衡器算出額外會話速率後,乘上回報間隔再加上目前的活躍會話數,就是真實的有效容量。
這種混合方法有助於解決即時 AI 工作量最核心的路由問題。舉例來說,一個有 10 個活躍會話但 CPU 用到 90% 的後端,每會話成本會非常高,額外會話速率會被壓到零,因此不會再收到新流量。相反地,一個有 80 個活躍會話但 CPU 只用 40% 的後端,看起來還有空間,但安全係數會確保它只會慢慢拿到新會話,避免突然被灌爆。
幫會話感知平衡做基準測試
驗證這些系統的標準測試方法,常常漏掉真正的故障模式。發送短請求突發流量的測試,主要測到的是請求吞吐量,沒辦法重現長期 AI 會話的行為。
有效的基準測試該涵蓋多個變數:併發會話數、會話持續時間、到達模式、閒置與活躍語音的比例、取消和斷線率、後端數量、每個後端的最大會話數。指標也得抓到串流行為。除了平均延遲和 QPS,還要追蹤後端間的活躍會話分佈、過載分配率、第 95 和第 99 百分位啟動延遲、首個串流的時間、丟棄會話與強制斷線後計數器的行為。目標是比較路由行為隨時間怎麼變化。
基於請求數的平衡常導致流量分配不均,某些後端累積一堆長期會話,其他的卻閒置。會話感知平衡則能更均勻地分配活躍對話,避免單一後端被潛在工作量壓垮。
驗證追蹤本身的開銷
即使是簡單的會話追蹤器,也位在關鍵路徑上。每次串流啟動、結束都會觸發它,所以在大規模併發下,得確保追蹤本身不會變成瓶頸。
對 JVM 服務來說,通常意味著要用適當的微基準測試框架,考慮 JIT 最佳化、JVM 預熱、死碼消除這些容易扭曲測試結果的因素。測試重點通常最好放在爭用(contention)而不是單執行緒延遲上。當多個執行緒或協程同時猛敲同一個計數器會發生什麼事?以 Java 為例,AtomicInteger 對很多工作量可能完全夠用,但在高併發下,多個執行緒不斷搶著更新同一個記憶體位址,會造成嚴重的快取行爭用。在高吞吐量場景,分片計數器或 LongAdder 風格的聚合方式可能更適合維持吞吐量。
會話追蹤成不成功,關鍵在可靠性,不是實作有多複雜。用來做負載平衡的每個信號都必須準確、低開銷,還要經過真實流量模式驗證過。
平衡的是會話,不是請求
即時 AI 把負載平衡的負擔從網路層轉移到了應用層級。QPS 告訴你到達狀況,CPU 揭露當下的壓力,活躍會話計數則指出真正已經承諾的併發量。
對語音、視訊或世界模型這類互動式 AI 工作量來說,最有效的路由策略是把這些信號綜合起來看。當後端能溝通清楚自己真實的會話狀態,負載平衡器就能做出更聰明的決策,避免任何單一實例變成瓶頸。
隨著 AI 代理進入生產環境,基礎架構也得跟上。要擴展這些系統,重點得從平衡離散的請求,轉移到平衡持續進行中的活躍對話。
●開發者:可參考 Google 提出的 session 層級監測與混合路由設計來優化自己的 AI 代理基礎設施
●投資人:AI 基礎設施與負載平衡領域的技術深化顯示市場對可靠部署方案的需求持續增長
●一般用戶:更穩定的實時 AI 服務體驗,較少出現回應延遲或服務中斷
重要性評分
🔴 高度重要
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Claude Skills 實作指南:打造可複用的 AI 代理與自動化任務
深入解析 Claude Skills 實作指南,學習如何打造可複用的 AI 代理與自動化任務。涵蓋環境設定、開發步驟與進階技巧,助您高效運用 Claude 應用提升工作效率。
閱讀指南 →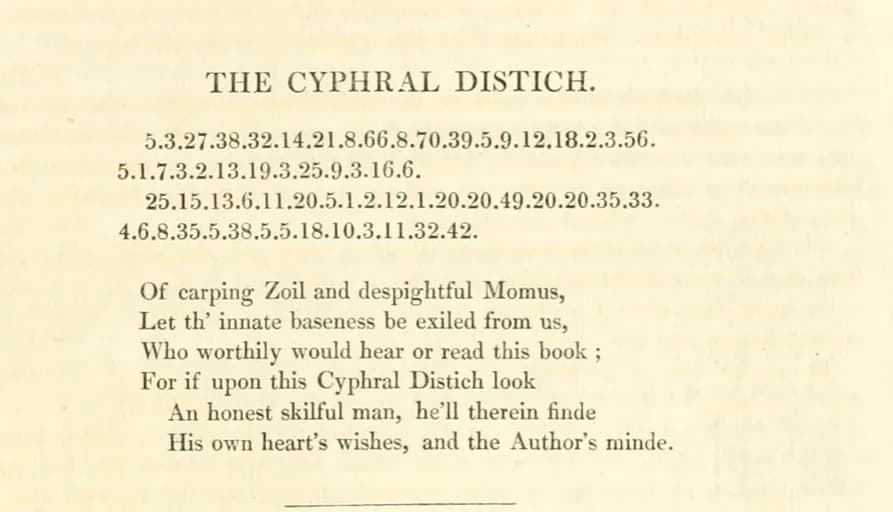
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。