研究突破
AutoViewMem:LLM 代理的自適應長期記憶系統
AutoViewMem: Self-Configuring Orthogonal Views for Conversational Long-Term Memory
arxiv.org2026-09-21
摘要
研究團隊推出 AutoViewMem,一套針對大語言模型代理設計的長期對話記憶框架。系統透過將記憶自動分解為多個低重疊語義視圖,解決傳統固定粒度記憶在處理混合型資訊(偏好、事件、約束、時間更新)時易產生語義干擾的問題,顯著改善檢索精準度。這項研究將語義解糾從檢索時前移至索引前,為 LLM 代理的長期一致性維護提供新思路。
LLM 代理記憶框架新方案:AutoViewMem 的語義視圖策略
由曹子傑、瞿希駿、顧志成等十位研究者組成的團隊近日在 arXiv 提出 AutoViewMem,這是一套針對大語言模型代理的長期對話記憶系統,用來解決現有記憶架構在處理複雜資訊時的結構性缺陷。
現有記憶系統的問題
傳統的 LLM 代理記憶系統通常採用固定粒度或靜態結構。當偏好、事件、約束與時間更新等異質性資訊混合存放在單一表示裡,這種設計容易產生語義干擾。干擾一多,檢索時的 top-K 相似度搜尋就對雜訊變得敏感,相關證據的排名反而會被拉低。
AutoViewMem 的核心設計
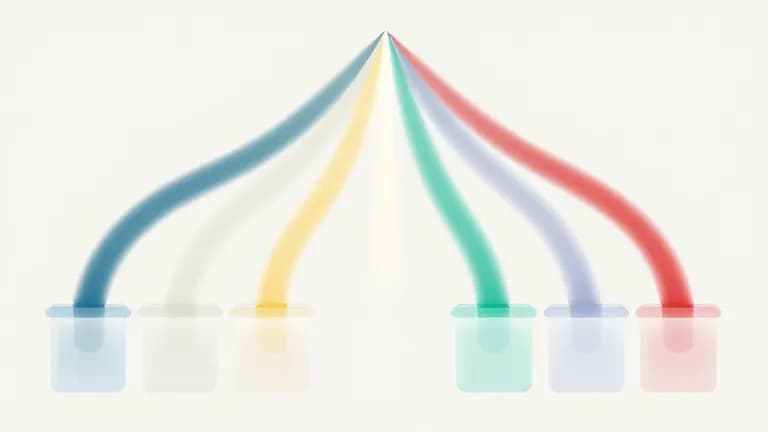
AutoViewMem 採取「先表示,後檢索」的做法。系統在索引前,會把長期對話記憶組織成自動配置、低重疊的語義視圖。整個流程分成三個環節:
首先,系統從交互軌跡中找出候選視圖;接著選出一組緊湊且互補的視圖集合;最後利用這些視圖在寫入階段進行結構化萃取,確保記憶有來源依據可查。
這種設計把語義解糾(semantic disentanglement)從檢索階段提前到寫入階段,讓標準的 top-K 相似度搜尋就能找到聚焦的證據,不需要額外依賴顯式路由或迭代檢索。
進一步優化
系統另外用了離線鞏固(offline consolidation)技術,讓記憶更緊湊、更一致。
實驗評估
研究團隊在 LoCoMo 和 PersonaMem 兩個基準上做評估,分別以 Qwen3-8B 和 Qwen3-14B 作為基礎模型。結果顯示,AutoViewMem 在長範圍問答與個性化任務上,相比現有記憶基線有所改進,同時推理流程仍維持簡潔。
該論文於 2026 年 9 月 18 日提交至 arXiv,歸類於人工智慧領域。
●開發者:可採用此框架改進 LLM 代理的記憶管理架構
●投資人:長期記憶系統是 AI 代理商用化的關鍵技術,值得關注此領域進展
●一般用戶:未來與 AI 助手的多輪對話將更具連貫性和個人化
重要性評分
🔴 高度重要
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

AI Agent 是什麼?怎麼用?2026 白話文入門完整說明
用 Anthropic 官方 Python SDK 寫出一個會自己決定何時呼叫工具的最小 AI Agent,附實跑結果與錯誤循環的防護做法。
閱讀指南
AI 研究員是什麼?OpenAI 自動化研究目標解析與職場生存指南
OpenAI 的目標是在 2028 年 3 月做出能在人類監督下工作的「自動化 AI 研究員」,並表示已達成「研究實習生」階段。本文整理官方說法、人類仍負責的判斷工作,以及與 AI 代理共事的做法。
閱讀指南
AI 機器人流量統計生存指南:自動化流量已超越人類,GA4 重構與歸因策略
Cloudflare 原本預測自動化流量會在 2027 年下半年超越人類,2026 年的創辦人信改說已提前到 2026 年 5 月。本文整理 GA4 如何排除機器人、怎麼看到 AI 爬蟲,以及 AI 代理比價後的歸因難題。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。