產品發佈
如何在 ADK 中評估 Live 與 Voice Agents
How to Evaluate Live & Voice Agents in ADK
Google Developers · 2026-10-03
摘要
Google 在 ADK 中新增原生 Live Evaluation 功能,讓開發者能針對基於 Graph 的 Agent 工作流程進行自動化測試。該功能結合 Gemini TTS 生成真實語音,透過自然語言評分標準自動評估語音回應與工具執行結果,並支援在 CI/CD 管道中直接運行。
Google 在 Agent Development Kit (ADK) 中引入原生 Live Evaluation 功能,旨在解決將 Live Voice Agents 從演示階段推向生產環境時,因真實多輪對話不可預測性而所需的嚴格自動化測試需求。此功能允許開發者針對基於 Graph 的 Agent 工作流程進行測試,並結合 LLM 驅動的模擬用戶(simulated users)來生成實際音訊(actual audio),該音訊生成技術採用 Gemini TTS。
在評估機制上,開發者可以定義評估場景(evaluation scenarios)並設定自然語言評分標準(natural-language rubrics)。系統會依據這些標準自動對音訊回應(audio responses)以及工具執行結果(tool executions)進行評分。這種設計讓測試過程不僅限於文字層面,更能涵蓋語音互動的真實表現。
為了方便開發者檢視與整合,ADK 提供了多種操作介面與管道。開發者可以在 ADK Web 介面中檢查生成的轉錄文字(resulting transcripts),以視覺化方式分析測試結果。此外,該功能支援直接透過命令列介面(CLI)執行評估,這使得 Live Evaluation 能夠無縫整合至 CI/CD 管線中,實現持續整合與持續交付流程中的自動化品質驗證。
●開發者:可透過 ADK 原生功能自動化測試語音 Agent 的穩定性與準確性
●投資人:Google 持續強化 Gemini 生態系與開發者工具鏈的完整性
●一般用戶:未來使用語音 AI 助手時,其回應品質與穩定度有望提升
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →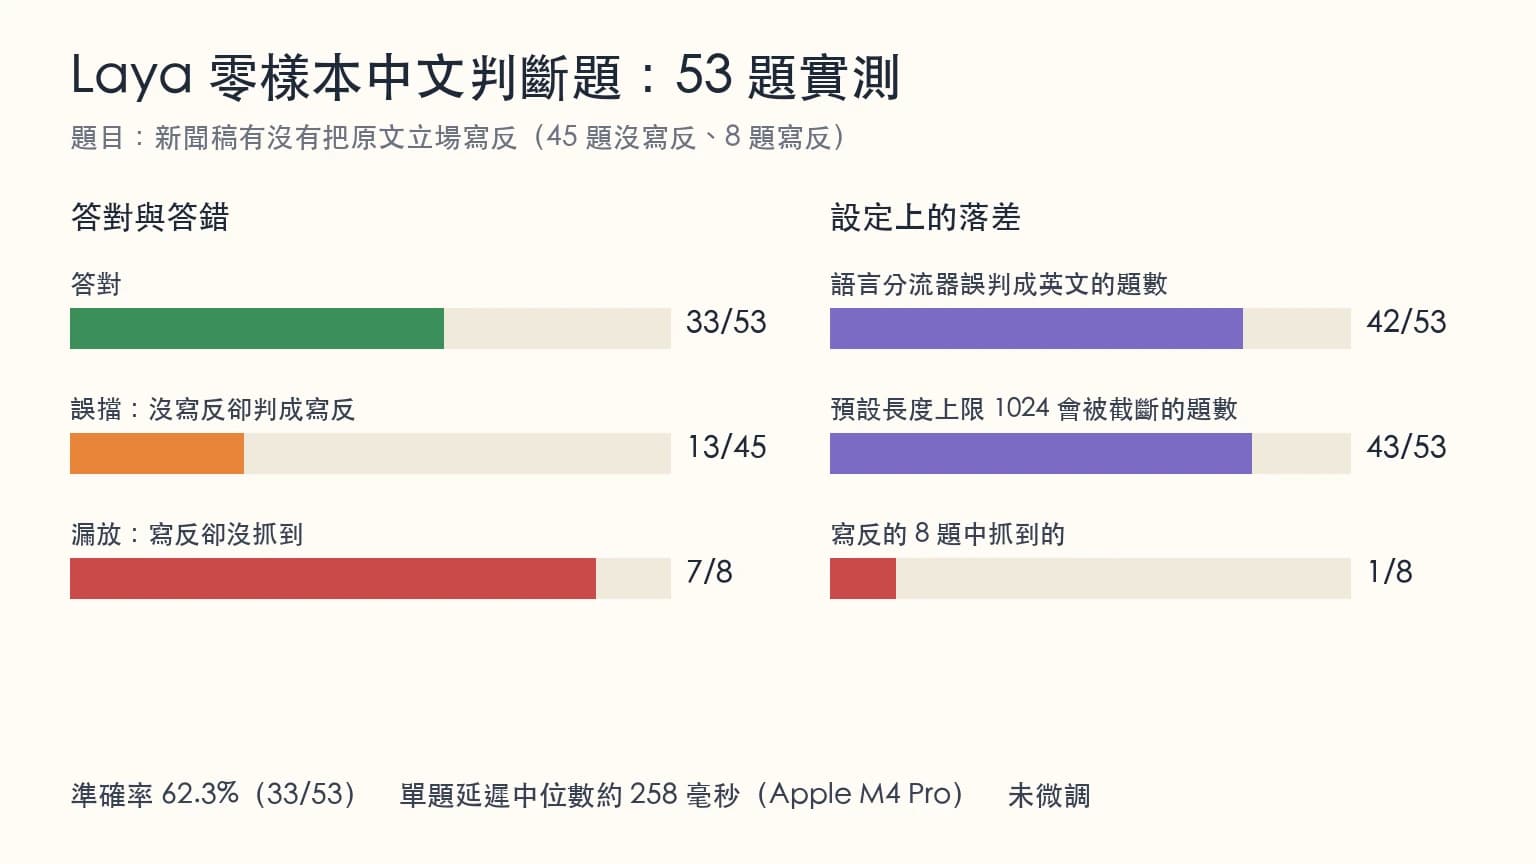
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →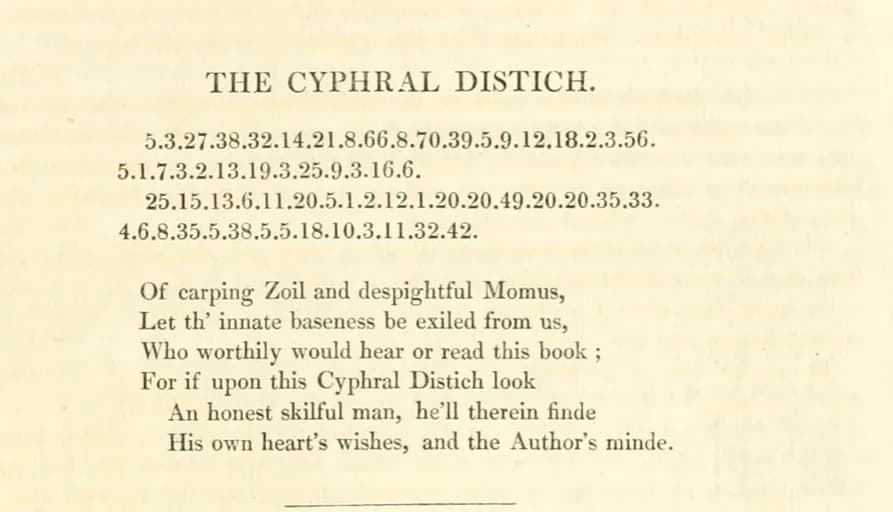
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。