研究突破
AutoIndexer:透過訓練因果模型於編輯鏈條,實現靈活順序解碼
AutoIndexer: Flexible-Order Decoding by Training Causal Models on Chains of Edits
arxiv.org · 2026-10-13
摘要
研究團隊提出 AutoIndexer,一種能模擬「編輯鏈條」的生成模型,解決傳統自回歸解碼無法事後修正輸出的限制。該模型透過預測標記符號來插入、替換或刪除 token,讓模型能像文字編輯器一樣靈活調整先前生成的內容,特別適合處理具有跨參考或未來依賴性的非因果順序資料。
突破自回歸限制:AutoIndexer 支援靈活順序解碼
Autodesk Research 團隊提出名為 AutoIndexer 的生成模型,目標是解決傳統自回歸解碼處理非因果順序資料時的局限。這個方法透過模擬「編輯鏈條」,讓模型能像文字編輯器一樣,在生成後插入、替換或刪除標記符號(token),藉此修正先前輸出的內容。這項技術特別適用於需要跨參考或處理未來依賴性的任務,例如生成具有內部一致性引用的長篇文件或程式碼。
解耦生成順序與顯示順序
傳統大型語言模型通常採用自回歸方式訓練。當資料呈現順序與因果方向一致時,效果顯著;但遇到章節編號、字數統計這類需要事後調整的任務,就顯得笨拙。現有擴散模型雖能部分緩解此問題,卻難以靈活插入或移除任意數量的 token。AutoIndexer 的核心創新,是把 token 的「生成順序」與「顯示順序」解耦。模型在生成時仍維持自回歸特性,保留 KV 快取與早停機制等優勢,但在最終輸出時,可根據編輯操作重新排列 token 的顯示位置。
該模型配備標記頭(marker head)與游標頭(cursor head)。標記頭負責預測正常詞彙、序列結束符號,或啟動與結束編輯的指令。游標頭則是雙頭指針網路,用來預測編輯的起始與結束索引。模型預測到編輯指令時,會把游標移到現有 token 序列中的特定位置,並重新分配位置編碼,讓新生成的 token 始終保持相對位置為 1。這種機制讓模型在生成過程中隨時能回頭修改已產生的內容,不受固定位置限制。
透過反向編輯操作進行訓練
AutoIndexer 的訓練採用類似擴散模型的自監督學習範式,但針對的是離散編輯操作。訓練序列的建構方式,是對真實標籤套用隨機的逆編輯操作(如插入、刪除、替換)。模型被訓練去「undo」這些逆操作,也就是學習如何修正被擾亂的上下文。這種方法讓模型能從任何序列資料集學習,不需要人類編輯歷史,也支援使用 git diffs 等真實歷史,針對特定任務進行微調。
為了處理多次編輯帶來的位置編碼挑戰,研究團隊開發了「鏈式編輯旋轉位置編碼」(Chain-of-Edits RoPE)。這是一種融合注意力核,能在單次前向傳播中計算多個編輯的相對位置編碼。它把注意力計算拆成多個片段,每個片段對應 token 位置單調增加的子序列。這樣的設計讓模型即使在非單調的顯示順序下,仍能精確使用 KV 快取,因為鍵和值是以未旋轉的形式緩存,計算注意力時才套用旋轉角度。
實驗結果與能力評估
AutoIndexer 8B LoRA 模型是在 Qwen3 8B 基礎模型上做 LoRA 微調,在標準 LLM 基準測試中表現優異。在一般任務、數學科學及程式碼生成方面,其性能與相同設定的 Qwen3 LoRA 基線相當,並持續優於其他擴散模型基線。尤其在 HumanEval 程式碼評估中,AutoIndexer 在未加指令的情況下大幅領先,顯示編輯訓練目標對程式碼任務具有特殊的遷移優勢。
在編輯能力評估中,AutoIndexer 展現了主動修正上下文的潛力。在自由生成設置下,模型在刪除、替換與無需修改的情況中,能以約 90% 的準確率區分受污染與乾淨的序列,並在近 70% 的刪除與替換案例中預測出正確的編輯範圍。刪除操作有 53 次精確修復,替換操作有 18 次精確修復。插入操作因缺乏明確線索而較具挑戰性,只有 43% 的受損草稿觸發了編輯,但編輯觸發時,有 60% 的情況能正確定位插入位置。這些結果證明,AutoIndexer 能在不犧牲標準生成能力的同時,讓模型具備持續編輯與自我修正的機制。
●開發者:可關注此新架構以改善非線性文本生成任務
●投資人:關注 NLP 基礎模型技術的演進方向
●一般用戶:未來 AI 生成內容的準確性與邏輯修正能力有望提升
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →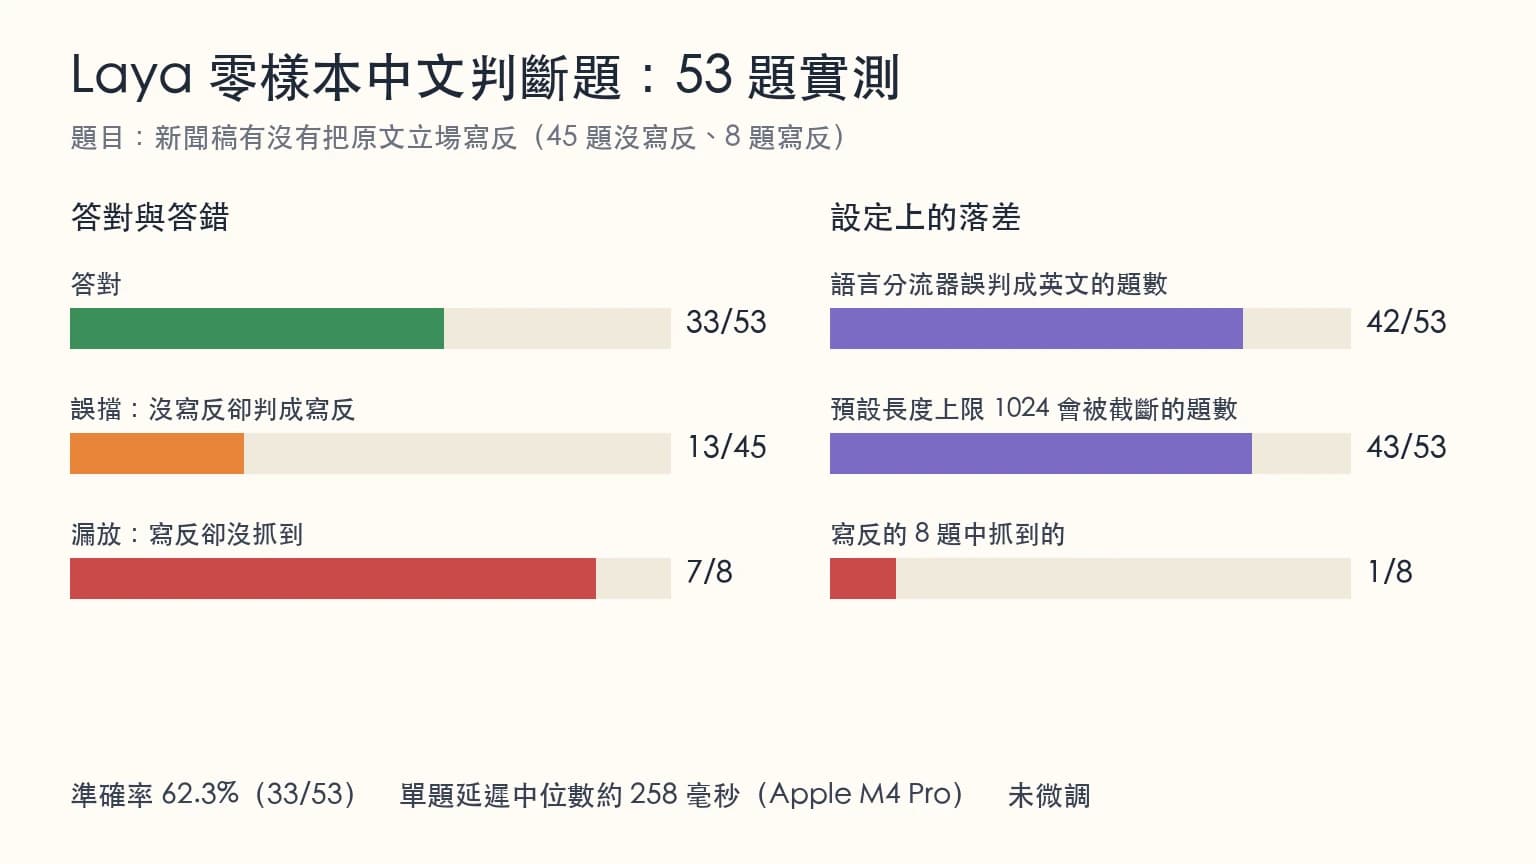
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。