研究突破
ClawLoop:透過 Harness-Native 訓練循環實現自我改進的 AI Agent
ClawLoop: Self-Improving Agents via Harness-Native Training Loop
arXiv cs.AI · 2026-10-15
摘要
研究團隊提出 ClawLoop 框架,解決現有基於 Harness 環境的 LLM Agent 缺乏自我改進能力的問題。該框架無需依賴外部教師模型或人類先驗知識,透過整合三個階段實現 Agent 的自主優化與能力提升。
研究團隊提出 ClawLoop 框架,解決現有基於 Harness 環境的 LLM Agent 缺乏自我改進能力、訓練管道依賴外部教師模型與人類先驗知識的問題。ClawLoop 整合任務合成、訓練、診斷與反饋三個階段,形成無需外部教師或人類先驗知識的自我維持循環,實現 Agent 自主優化。
在任務合成階段,系統透過兩種互補的建構常規生成多樣化訓練任務池,應用診斷條件下的難度增長,並進行無 Agent 與有 Agent 的任務驗證。訓練階段利用監督式微調(SFT)與強化學習(RL)更新 Agent。診斷與反饋階段分析 Agent 的 rollout 行為,產生能力分析報告,作為下一輪任務合成的反饋依據。
實驗以 Qwen3.6-27B 為循環模型,進行 K=3 次迭代,每次生成 1,024 個新訓練任務。每個任務進行 N=8 次 rollout 以進行驗證與 SFT,並設定 Nl=1、Nh=5 過濾過於簡單或困難的任務。結果顯示,ClawLoop 在 SkillsBench、Claw-Eval-Live 和 ClawGym-Bench 上均獲得一致的性能提升。
研究團隊將迭代優化的任務轉移至較小規模的 Qwen3.5-4B 和 9B 模型進行訓練。
●開發者:可關注無需外部教師模型的 Agent 自我訓練架構
●投資人:AI Agent 基礎設施與自動化訓練領域值得留意
●一般用戶:此技術主要影響後端開發,對日常使用無直接影響
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
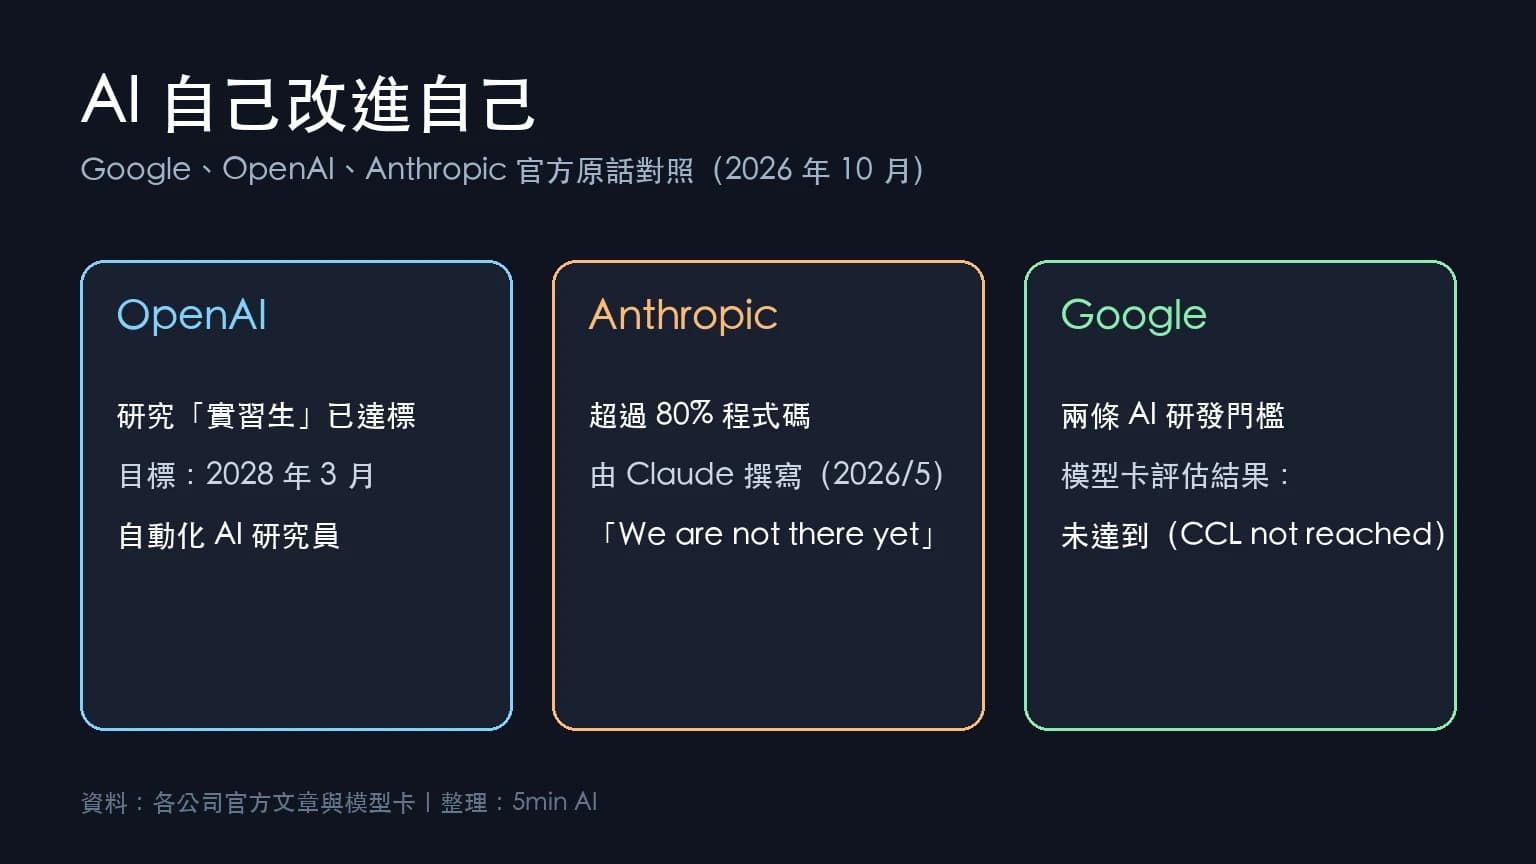
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →
Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。