研究突破
Hugging Face 發布了關於印地語(Indic)預訓...
Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline
huggingface.co · 2026-10-16
摘要
Hugging Face 發布了關於印地語(Indic)預訓練模型的技術報告,該模型使用了 2.8 兆 token 的數據量進行訓練。同時,團隊公開了一套開放的數據生成管道(Open Data Generation Pipeline),旨在提升多語言模型的訓練效率與數據品質。
●開發者:可參考其開放的數據生成管道與大規模預訓練方法
●投資人:關注多語言 AI 基礎設施的技術進展
●一般用戶:印地語等語言的 AI 服務準確度有望提升
重要性評分
65/100
🟠 值得關注
Hugging FaceIndic PretrainingOpen Data Generation Pipeline多語言 AI大規模預訓練
原文出處喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Gradio 部署 AI 工作流程教學
Gradio 部署 AI 工作流程教學:從零開始串接模型並上線實戰指南
想快速將 AI 模型變成可運行的網頁應用?本文提供 Gradio 部署 AI 工作流程教學,涵蓋環境設定、模型串接、雲端部署及最佳實踐,幫助開發者從零開始完成實戰上線。
閱讀指南 →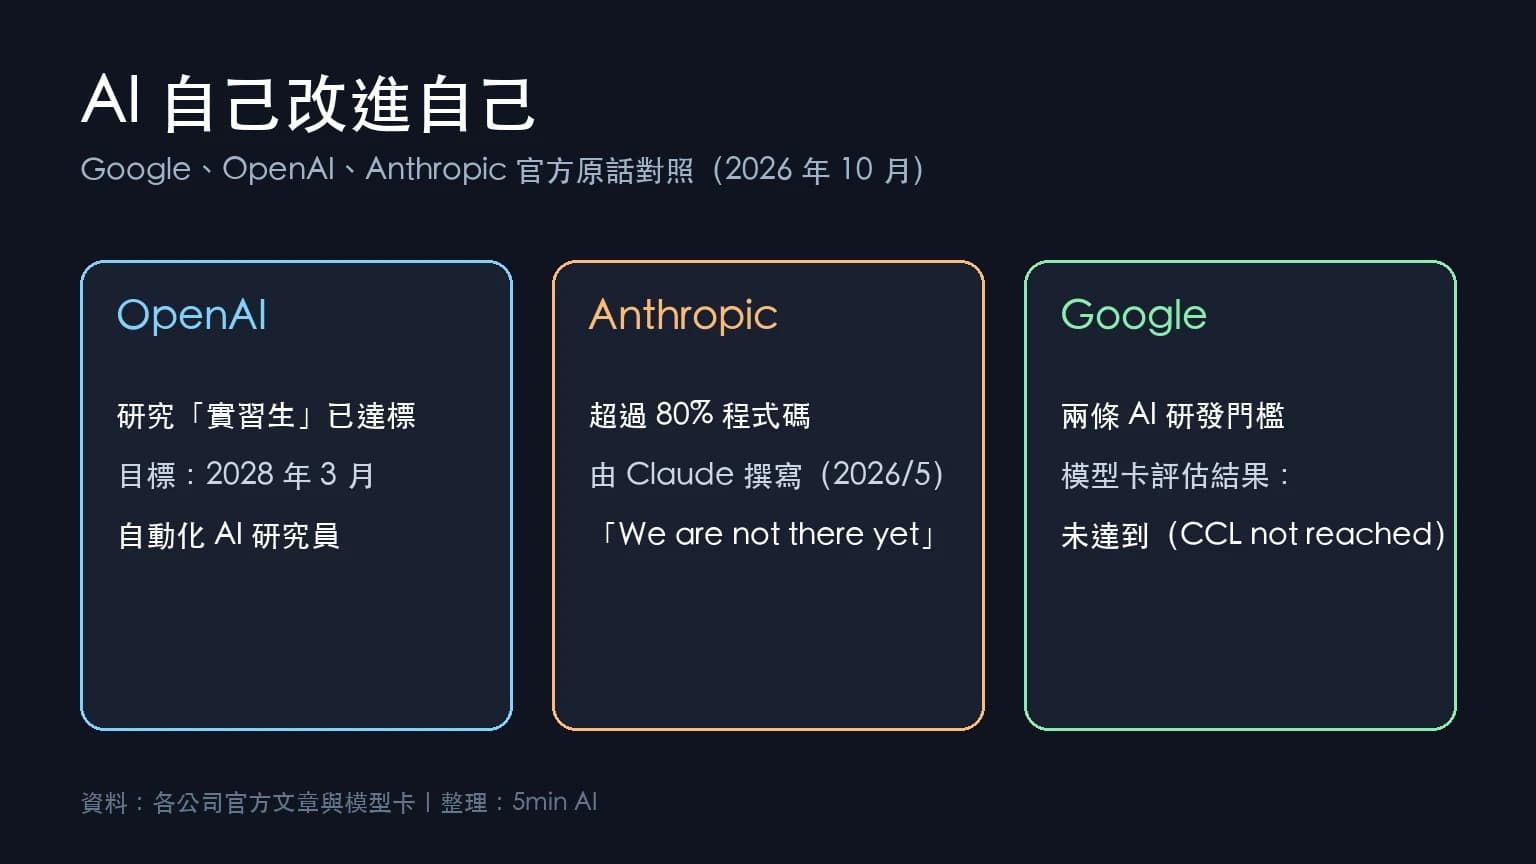
AI 自我改進 RSI
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南 →
google ai studio vibe coding 教學
Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。