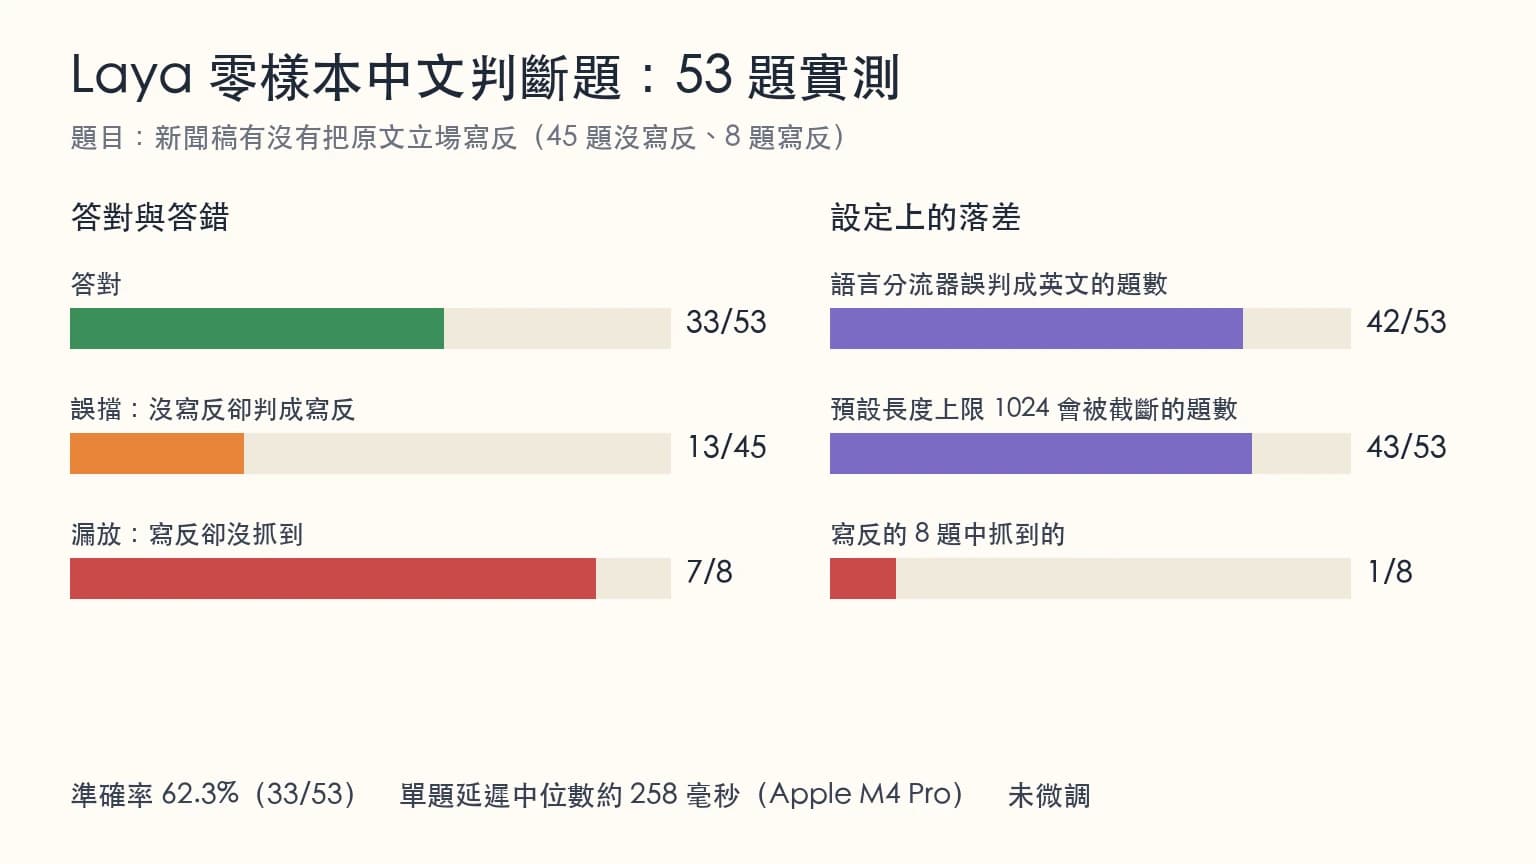
Laya 是 Convai Innovations 在 9 月 18 日放上 Hugging Face 的開源模型,Apache 2.0 授權,官方標示英文版 4.21 億、多語版 3.22 億個參數(我們實測的是多語版),README 標示多語版在 T4 顯卡上回答一題約 32.8 毫秒。我們拿它做了一件官方沒特別示範的事:不微調、不教它任何範例,直接丟一道中文長文判斷題,看它答得如何。53 題跑完,準確率是 62.3%。這篇整理我們怎麼測、哪裡出了狀況,以及如果你也想試,設定上有哪幾個地方要先注意。
Laya 是什麼:不寫字、只做選擇題的小模型
一般的大型語言模型會一個字一個字生成答案。Laya 不是這種模型。官方 README 說它是「非自回歸」(non-autoregressive)模型:一次運算就直接回傳有型別的答案和機率,不逐字生成文字。
它只回答三種「有型別的問題」:
choice:從幾個選項裡選一個,例如「這封客訴屬於帳務、技術還是其他」。score:給一個順序等級。noul:是或否,回傳一個機率。
這類模型有時被稱為 System 1 模型,意思是像人的直覺反應那樣,一眼判斷、快速給答案,不做長串推理。
官方 README 的說法是:出貨的 checkpoint(模型權重版本)可以零樣本(zero-shot,也就是沒看過任何範例就直接作答)使用,但微調才是準確率大幅提升的地方。在 README 的 typed-decisions 測試上,基礎英文版準確率是 0.362,微調版是 0.766;README 也寫明,基礎版在這個測試上零樣本接近隨機猜測。我們這次測的是零樣本,沒有微調。我們想知道的是:如果有人不想標資料,直接拿來用,會發生什麼事。
我們怎麼測:一道「立場有沒有被寫反」的判斷題
題目是這樣的:給模型一篇英文原文,再給一篇我們寫的繁體中文新聞稿,問它「新聞稿有沒有把原文的立場寫反」。例如原文在批評某個安全問題,稿子卻寫成稱讚。要答對,模型必須真的把兩段文字對照著看。
題庫共 53 題:
- 45 題是真實稿件,人工確認沒有寫反。
- 8 題是我們刻意改寫出來的立場寫反稿,其中 4 題寫得很直白(把批評直接換成稱讚詞),4 題比較隱晦。
每題的輸入是原文(最多取 8,000 字)加上中文稿。我們用本機的 Apple M4 Pro(蘋果晶片的 GPU 加速)跑,套件是 PyPI 上的 laya 0.3.20。
結果:62.3%,而且抓不到寫反的稿子
先定義兩個詞:誤擋=把沒寫反的判成寫反,漏放=把寫反的判成沒事。
| 項目 | 數字 |
|---|---|
| 答對 | 33 / 53(62.3%) |
| 誤擋(沒寫反卻判成寫反) | 13 / 45 |
| 漏放(寫反卻沒抓到) | 7 / 8 |
| 直白的 4 題抓到 | 0 / 4 |
寫反的 8 題只抓到 1 題。連最直白、把批評換成「卓越」「領先」這類讚揚詞的 4 題,也一題都沒抓到。
我們另外把模型給的「寫反機率」當成分數,看它能不能把寫反的稿子排在前面。結果是分數和答案看不出關聯:整體傾向是沒寫反的真實稿拿到的「寫反機率」反而比人工改寫的寫反稿更高(寫反的只有 8 題,我們不據此下強結論)。我們也掃了不同的判定門檻,沒有找到一個能兼顧的點:
| 門檻(機率超過就判寫反) | 沒寫反的 45 題被誤擋 | 寫反的 8 題抓到 |
|---|---|---|
| 0.3 | 38 題 | 5 題 |
| 0.5 | 13 題 | 1 題 |
| 0.7 | 1 題 | 0 題 |
門檻低就幾乎全擋,門檻高就幾乎全放。
它有沒有在比對原文?兩個檢查都看不出來
62.3% 不等於「模型有在比對,只是比對得不太準」。我們做了兩個檢查,想知道它的答案到底跟什麼有關。
檢查一:拿掉原文。 把原文換成「(未提供)」再問一次。8 題寫反的稿子,有原文時判成寫反的是 1 題,沒有原文時還是 1 題。原文有沒有給,答案沒變。
檢查二:同一篇原文,配對兩份稿子。 8 題寫反的稿子和 45 題裡的某些真實稿共用同一篇原文,只有中文稿不同。如果模型在比對,寫反的那份機率應該比沒寫反的那份高。結果 8 組裡只有 3 組方向正確,亂猜的期望值是 4 組。
13 題誤擋也有個規律:它們只來自 6 個新聞故事,其中 5 個故事是「該故事的每一份稿子都被判成寫反」,例如某份威脅報告的 4 份稿子全被判寫反。答案跟著原文走,不跟著稿子走。
在這 53 題裡,看不出答案和稿子內容有關。
覺得有用?每天 5 分鐘掌握 AI 新工具
免費訂閱,新工具搶先看,隨時可取消
設定上的兩個坑
即使是測到這一步,我們也先懷疑過是不是自己用錯了。以下兩點是實測中確認的:
語言分流器會選錯 checkpoint。 Laya 有個 Router,會根據文字判斷該送去英文版還是多語版。我們的輸入是英文原文加中文短稿,字母統計上英文佔壓倒性多數。53 題裡有 42 題被判成英文,會被送進讀不懂中文題目的 checkpoint。解法是自己指定 model="multilingual",不要讓 Router 決定。
預設長度上限太短。 多語版的預設 max_len 是 1024,README 對長文件的建議是設成 8192。我們的題目送進模型的 token 數中位數是 2,254、最大 3,840,用預設值的話 53 題裡有 43 題會被截斷。我們的主要結果都是照官方建議設成 8192 跑的,8192 沒有任何一題被截,所以上面的錯誤不能歸咎於長度。
我們還試過其他配置:題目改寫成英文、改用英文版或 typed-decisions checkpoint、把題目縮成一句。沒有一種在這道題上達到可用的程度。安裝本身也沒問題,README 的範例和一組繁中客服分流題(重複扣款分到帳務、設定閃退分到技術)都答對了。
優點也要寫清楚
- 完全決定性。 同樣 53 題重跑第二次,判定全部相同,機率的差距是 0。沒有取樣,就沒有隨機性。
- 快。 本機蘋果晶片的 GPU 加速下,帶著 2,000 多個 token 的輸入,單題中位數約 258 毫秒。README 的 32.8 毫秒是短輸入、T4 顯卡的數字,兩者條件不同,不能直接比。53 題總共跑了約 13.4 秒。
- 免費、可離線。 Apache 2.0,跑在自己的機器上,沒有 API 費用。
這個結果的限制
這份實測能支持的結論很窄,請別把它讀成對模型的整體評價:
- 只有一個任務。 我們測的是「立場有沒有被寫反」,需要把兩段長文對照著讀。分類、分流這類單段文字的任務,我們只做了 README 範例與兩題繁中客服題的健康檢查,不算評測。
- 題數少。 N=53,其中只有 8 題是寫反的,而且是我們自己寫的,不是真實世界出現的樣本。
- 沒有微調。 README 說微調才是準確率大幅提升的地方,我們沒有測。我們手上的 8 題寫反樣本也不夠拿來訓練。
所以更準確的講法是:在這個任務、零樣本、中文、長文比對的條件下,我們沒有找到可用的操作點。微調之後會怎樣,這份實測回答不了。
想自己試的話:實用建議
- 自己指定
model="multilingual"。 只要輸入有中文,別讓 Router 猜,尤其是中英混雜的長文。 - 把
max_len設成 8192。 長文件用預設的 1024 會被截斷,模型看到的不是完整內容。 - 先拿自己的題目抽測,再決定要不要上線。 我們的做法是準備一批已知答案的題目,其中必須有「應該被抓到」的樣本,看它抓不抓得到。只看整體準確率不夠:如果你的資料 85% 都是「沒問題」,什麼都答沒問題就有 85%。
- 做「拿掉關鍵資訊」的對照。 如果任務需要比對兩段文字,就把其中一段換成空白再問一次。答案不變,代表它可能根本沒在看那一段。
- 要用就準備微調。 README 說微調才是準確率大幅提升的地方。要微調,就要有足夠、真實的標註資料。
常見問題 FAQ
Laya 是什麼?
Laya 是 Convai Innovations 在 Hugging Face 釋出的開源模型,Apache 2.0 授權。它不生成文字,只回答 choice、score、noul 三種有型別的問題。官方 README 說出貨的 checkpoint 可以零樣本使用,但微調才是準確率大幅提升的地方(基礎英文版 0.362、微調版 0.766,是 README 的 typed-decisions 測試);我們測的是零樣本。
Laya 支援中文嗎?
有多語版 checkpoint(3.22 億參數),我們的測試也是用它跑繁體中文題目。使用時要自己指定 model="multilingual",並把 max_len 設成 8192,否則預設的分流和長度限制都可能出問題。
這次實測的準確率是多少?
在我們設計的「新聞稿立場有沒有被寫反」這道題上,零樣本、53 題,準確率 62.3%(33/53)。這只代表這個任務與這個條件,不代表 Laya 在其他任務上的表現。
微調之後會變好嗎?
官方 README 說明微調後在它自己的 typed-decisions 測試上,準確率從基礎英文版的 0.362 提升到 0.766。我們沒有測微調,所以無法說明在我們這道題上會改善多少。
說明:本文數字來自我們自己的離線測試(53 題、單一任務、未微調),官方數字引自 Laya 的 Hugging Face README。
常見問題 FAQ
Laya 是什麼?▼
Laya 支援中文嗎?▼
這次實測的準確率是多少?▼
微調之後會變好嗎?▼
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
延伸閱讀
Claude Code Artifacts 是什麼:即時預覽與互動功能解析
深入解析 Claude Code Artifacts 是什麼,掌握其即時預覽與互動功能。本文提供完整的 Claude artifacts 教學,並分析 claude code 新功能對開發者介面的影響。
canva ai vs photoshop aiCanva AI vs Photoshop AI:2026 年設計工具怎麼選
2026 年 Canva AI vs Photoshop AI 功能比較。深入分析 Canva AI 功能與 Photoshop AI 生成能力,協助您選擇最適合的 AI 設計工具推薦方案。
vibe coding cursor 教學Vibe Coding 是什麼?Cursor 實戰教學與最佳實踐
深入解析 Vibe Coding 概念,提供 Cursor 實戰教學與使用技巧。掌握 AI 輔助程式設計,從零開始打造高效開發流程的最佳實踐指南。
perplexity deepseek 比較Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
資料來源:https://huggingface.co/convaiinnovations/laya
本指南由 AI 整理,功能、價格與規格請以官方網站為準。如有疑慮,請參閱編輯政策。