研究突破
AI 評測機制失效,我們需要新的評估標準
AI benchmarks are broken. Here’s what we need instead.

MIT Tech Review · 2026-03-31
摘要
傳統以人類表現為基準的 AI 評測方式已無法準確反映模型能力,導致評測結果失真。文章指出需要建立新的評估框架,以取代過時的「AI 對決人類」思維,這對於確保技術發展方向正確至關重要。
●開發者:需重新思考模型評估指標與基準測試方法
●投資人:應關注具備新評估體系的 AI 項目
●一般用戶:未來將獲得更可靠的 AI 產品體驗
重要性評分
78/100
🟠 值得關注
AI 評測模型評估技術基準MIT Tech Review人工智慧
原文出處喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

AI 人工智慧是什麼 零基礎
AI 是什麼意思?零基礎也能看懂的人工智慧完整說明
AI 是什麼?本文不用任何技術背景,用生活化的例子解釋人工智慧(AI)的定義、機器學習是什麼、為什麼 AI 最近突然變厲害,以及 AI 在日常生活中的實際應用。
閱讀指南 →
perplexity vs chatgpt
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →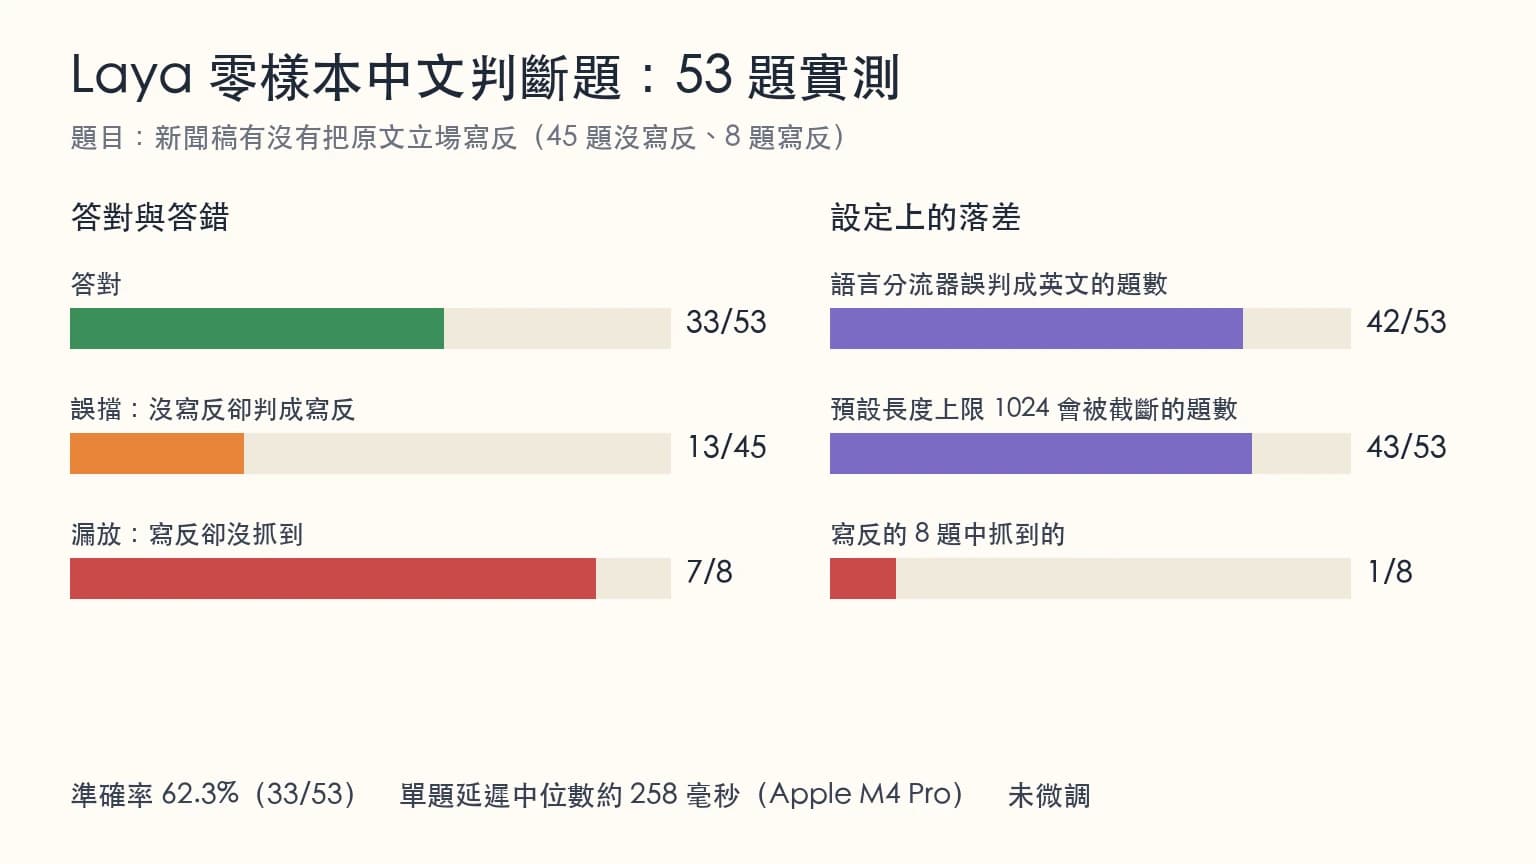
Laya 開源模型
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。