研究突破
SIEVE:樣本高效自然語言參數化學習新方法
SIEVE: Sample-Efficient Parametric Learning from Natural Language

arXiv cs.LG · 2026-04-06
摘要
研究團隊提出 SIEVE 方法,能利用自然語言上下文僅透過三個範例即可實現參數化學習,大幅降低對大量數據的依賴。該技術透過 SIEVE-GEN 合成數據生成管道與上下文蒸餾技術,將外部知識內化至模型權重中,解決了傳統參數化學習數據需求過高的痛點。這代表未來模型能更靈活地透過對話或指令快速適應新任務,無需重新訓練龐大數據集。
研究團隊提出 SIEVE 方法,旨在實現樣本高效(sample-efficient)的自然語言參數化學習,該方法僅需三個查詢範例(query examples)即可運作。此技術針對傳統參數化學習數據需求過高且依賴高品質痕跡(high-quality traces)或自動化驗證器(automated verifiers)的痛點,利用自然語言上下文中的豐富信號進行模型適應。
SIEVE 的核心機制包含一個名為 SIEVE-GEN 的合成數據生成管道,該管道基於上下文可分解(context is decomposable)的洞察。透過將上下文分解,系統能將合成查詢與適用的上下文配對,而非使用完整上下文,從而生成更高品質的輸出(rollouts)。隨後,研究團隊利用上下文蒸餾(context distillation)技術,將外部知識內化至模型權重中。
研究團隊在需要上下文的推理設定(reasoning settings)中對該方法進行了評估,測試範圍涵蓋自訂領域(custom domains)以及 R 相關任務。SIEVE 的提出顯示了透過自然語言上下文進行參數化學習的可行性,並大幅降低了對大量數據的依賴。
●開發者:可關注 SIEVE 技術以優化模型微調流程
●投資人:應留意樣本高效學習領域的潛力
●一般用戶:未來 AI 將能更快速適應個人化需求
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Google Sheets Gemini 怎麼用?告別繁瑣公式,自然語言自動生成圖表與數據分析實戰
想知道 Google Sheets Gemini 怎麼用?本文提供完整教學,教你如何用自然語言指令自動生成公式、分析數據及製作圖表,讓 Excel 技能不再重要,輕鬆提升工作效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →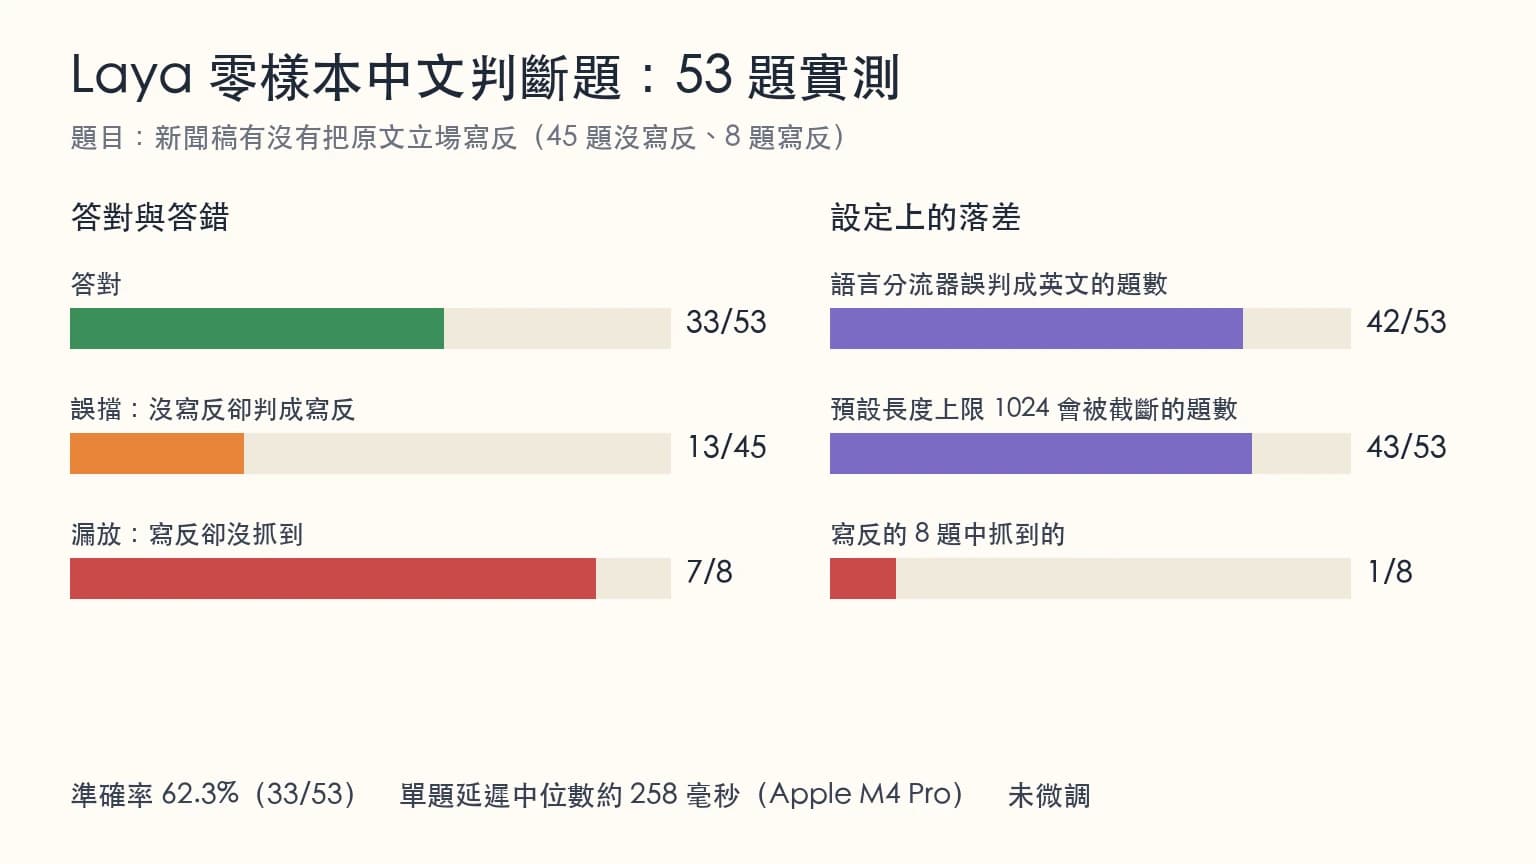
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。