垂直產業
臨床現場抑鬱症檢測:從常規初級保健對話中自動分析語言信號
Depression Detection at the Point of Care: Automated Analysis of Linguistic Signals from Routine Primary Care Encounters
arXiv cs.AI · 2026-04-09
摘要
研究人員開發了一套自動化系統,能從初級保健診療對話中檢測患者是否罹患抑鬱症。使用 GPT-OSS 零樣本模型在 1,108 場錄音就診中達到最佳效能(AUROC=0.774),發現醫患雙向對話的語言信號結合能更準確識別抑鬱症,特別是當醫療提供者在語言上「鏡映」患者時。這項技術可望改善初級保健中抑鬱症的低診斷率問題。
研究針對初級保健中抑鬱症診斷不足的問題,利用數位書寫技術日益普及的背景,探討如何從自然對話中自動檢測抑鬱症。研究基於「Establishing Focus」研究計畫,分析了 1,108 場錄音的初級保健會談,其中包含 253 例符合 PHQ-9 標準的抑鬱症案例與 855 例非抑鬱症案例。
研究比較了三種監督式方法(Sentence-BERT + Logistic Regression、LIWC+LR 以及 ModernBERT)與零樣本 GPT-OSS 模型的效能。結果顯示,GPT-OSS 表現最佳,達到 AUROC 0.774 與 AUPRC 0.510;在監督式模型中,LIWC+LR 表現最具競爭力,AUROC 為 0.742,AUPRC 為 0.500。
分析發現,結合醫患雙向對話的語音轉錄(Combined dyadic transcripts)優於單一說話者配置。研究指出,在抑鬱症會談中,醫療提供者會在語言上「鏡映」患者,這種雙向互動產生的訊號是單一說話者無法捕捉的額外資訊。此外,僅使用前 128 個患者詞元(tokens)即可實現有意義的檢測(AUROC 0.675, AUPRC 0.356),這支持了即時臨床決策支援的可行性。研究主張,被動收集的臨床語音應作為現有篩選流程的低負擔補充。
●開發者:可探索 GPT-OSS 和 ModernBERT 在臨床語言理解的應用潛力
●投資人:AI 輔助診斷在初級保健市場的商業化潛力值得關注
●一般用戶:未來看診時可能無需額外篩檢,系統能自動偵測抑鬱症風險
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →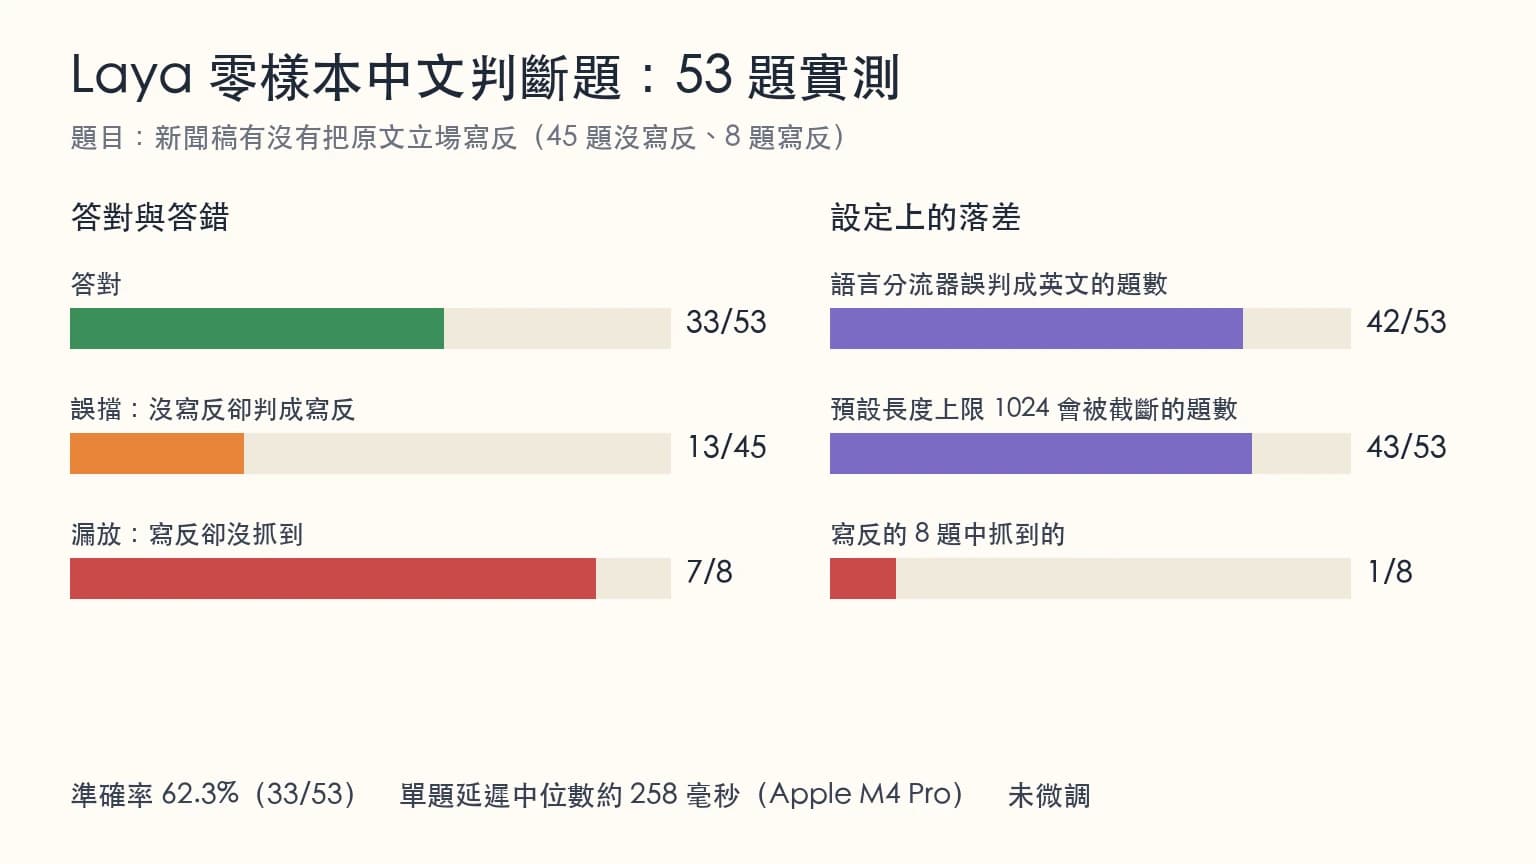
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →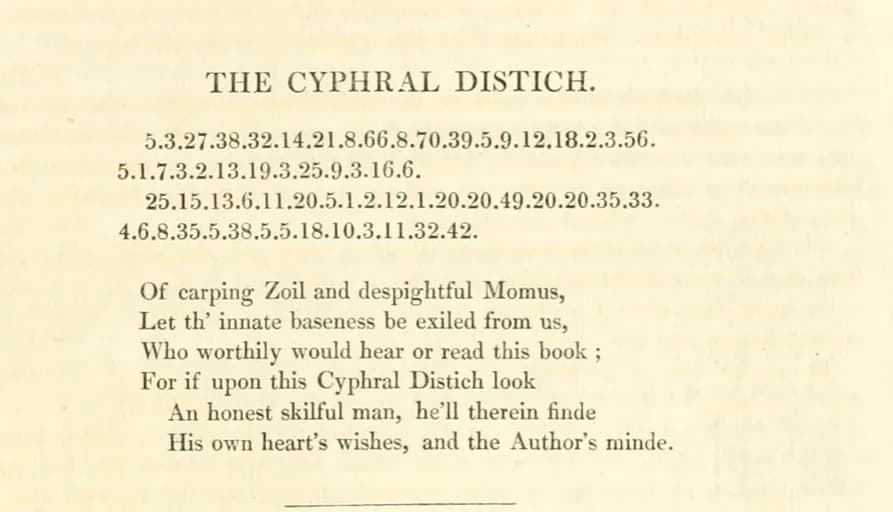
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。