安全倫理
超越表面判斷:LLM 生成虛假信息的人類基準風險評估
Beyond Surface Judgments: Human-Grounded Risk Evaluation of LLM-Generated Disinformation

arXiv cs.AI · 2026-04-10
摘要
研究團隊審計了 LLM 作為評判者的可靠性,發現大型語言模型在評估自身生成的虛假信息時,與人類讀者的評判存在顯著偏差。研究基於 290 篇文章和 2,043 份人類評分,發現 LLM 評判者通常更嚴苛、無法準確復現人類排序邏輯,且依賴不同的文本訊號,這對虛假信息風險評估的可靠性提出重要警示。
大型語言模型(LLM)的普及使得大規模生成欺騙性內容變得日益容易,這促使研究團隊需要建立基於讀者是否認為內容可信以及是否願意分享的可擴展虛假信息風險評估機制。研究團隊提出了一種自然方法,即直接向 LLM 詢問這些問題,並將返回的評分視為對應人類評分的預測,但這種做法隱含了一個假設:詢問讀者反應會產生最能預測該反應的評分。
研究團隊利用來自 317 名參與者的 290 篇欺騙性文章,以及八個 LLM 評估者,對該假設進行了測試。結果顯示,該假設在評估「可信度」(credibility)時成立,但在評估「分享意願」(willingness-to-share)時失敗。對於每一個評估者而言,可信度評分追蹤人類分享行為的緊密程度,至少與分享評分追蹤人類分享行為的緊密程度相當。
數據分析進一步表明,在預測對未見情境的反應時,分享評分除了可信度之外,沒有提供任何可檢測到的額外益處。無論問題是單獨詢問還是以相反順序詢問,這種模式都持續存在。研究結果暗示,直接詢問目標反應可能並非總是產生預測該反應的最有效評分。
研究指出,將直接評分與通過相關判斷的間接路徑進行比較,可能會揭示出更有效的預測路徑。這表明,決定詢問什麼問題(Deciding what to ask)與如何詢問(refining how to ask)同樣重要。
●開發者:需重新評估 LLM 作為自動評判工具的有效性,考慮混合人類反饋的設計
●投資人:AI 安全檢測和內容審核領域的技術挑戰凸顯,自動化方案成本優勢受質疑
●一般用戶:LLM 生成虛假信息的風險控制機制需加強,自動檢測工具的可信度存疑
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →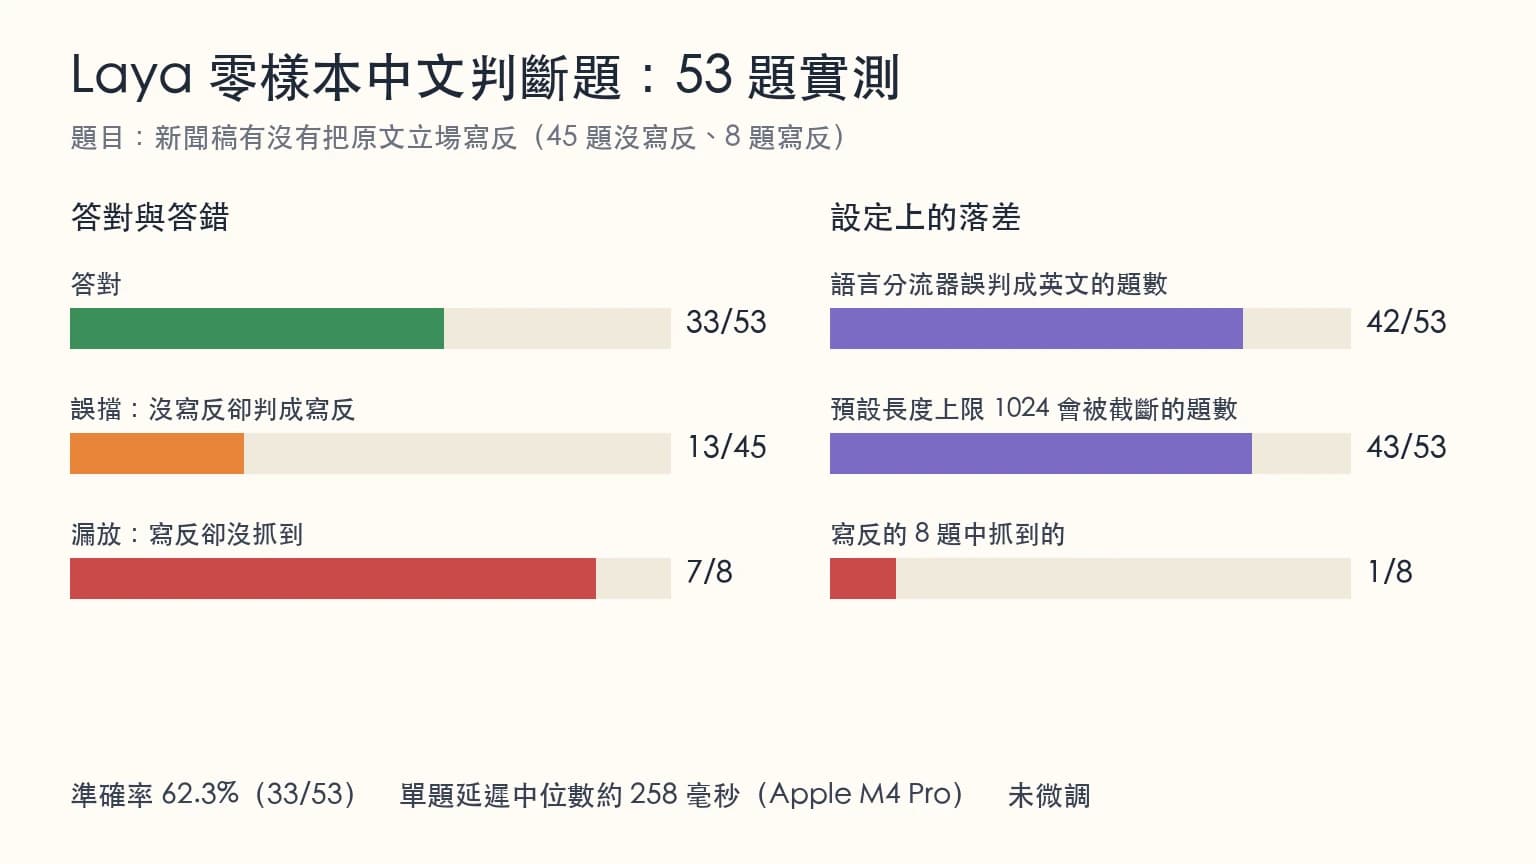
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。