研究突破
小秩序大作用:LoRA 適配器搭配隨機骨架網路已足夠
A Little Rank Goes a Long Way: Random Scaffolds with LoRA Adapters Are All You Need

arXiv cs.LG · 2026-04-13
摘要
一項新研究 LottaLoRA 發現,神經網路的完整參數中只有極小部分編碼任務特定信息。通過凍結隨機初始化的骨架權重,僅訓練低秩 LoRA 適配器,即可在從單層分類器到 900M 參數 Transformer 等多種架構上恢復 96-100% 的完整訓練性能,同時僅訓練 0.5-40% 的參數。這項發現揭示了神經網路參數效率的新視角,對模型設計和訓練有重要啟示。
一項名為 LottaLoRA 的新研究針對神經網路參數中實際編碼任務特定信息的比例進行調查。該研究提出了一種訓練範式,其中所有骨架權重均隨機初始化並凍結,僅訓練低秩 LoRA 適配器。在涵蓋從單層分類器到 9 億參數 Transformer 等多種架構的九個基準測試中,這種方法僅訓練 0.5% 至 40% 的參數,卻能恢復完整訓練性能 96% 至 100% 的表現。
研究揭示了三個機制性發現:首先,凍結的骨架在靜止狀態下會被積極利用,當學習到的縮放係數 $\beta$ 在所有架構中保持嚴格正值時,若骨架被破壞,優化器會使其靜默,由 LoRA 因子吸收所有任務信息;其次,凍結的骨架雖是首選,但任何隨機初始化均可互換,前提是其在整個訓練過程中保持固定;第三,性能飽和所需的最低 LoRA 秩估計了任務的內在維度,這類似於主成分分析(PCA)中保留的分量數量。
該構建在形式上等同於沿著前饋網路深度軸展開的儲層計算(Reservoir Computing)。由於骨架僅由隨機種子決定,模型可作為適配器與種子分發,其存儲與記憶體佔用隨任務複雜度而非模型大小增長,從而隨著架構擴展產生複合式的節省效果。
●開發者:可考慮採用 LoRA 適配器進行高效微調,顯著降低訓練計算成本
●投資人:參數高效化技術的突破可降低 AI 模型部署成本,對邊際利潤改善有積極意義
●一般用戶:輕量化模型訓練將使個人設備上的 AI 應用更加可行
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Publora 教學:繁中完整上手指南(功能、免費版、實測)
Publora 教學完整指南,深入解析 Publora 是什麼、Publora 怎麼用。涵蓋繁中介面設定、Publora 免費版功能實測與進階技巧,助您快速上手 AI 寫作工具。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →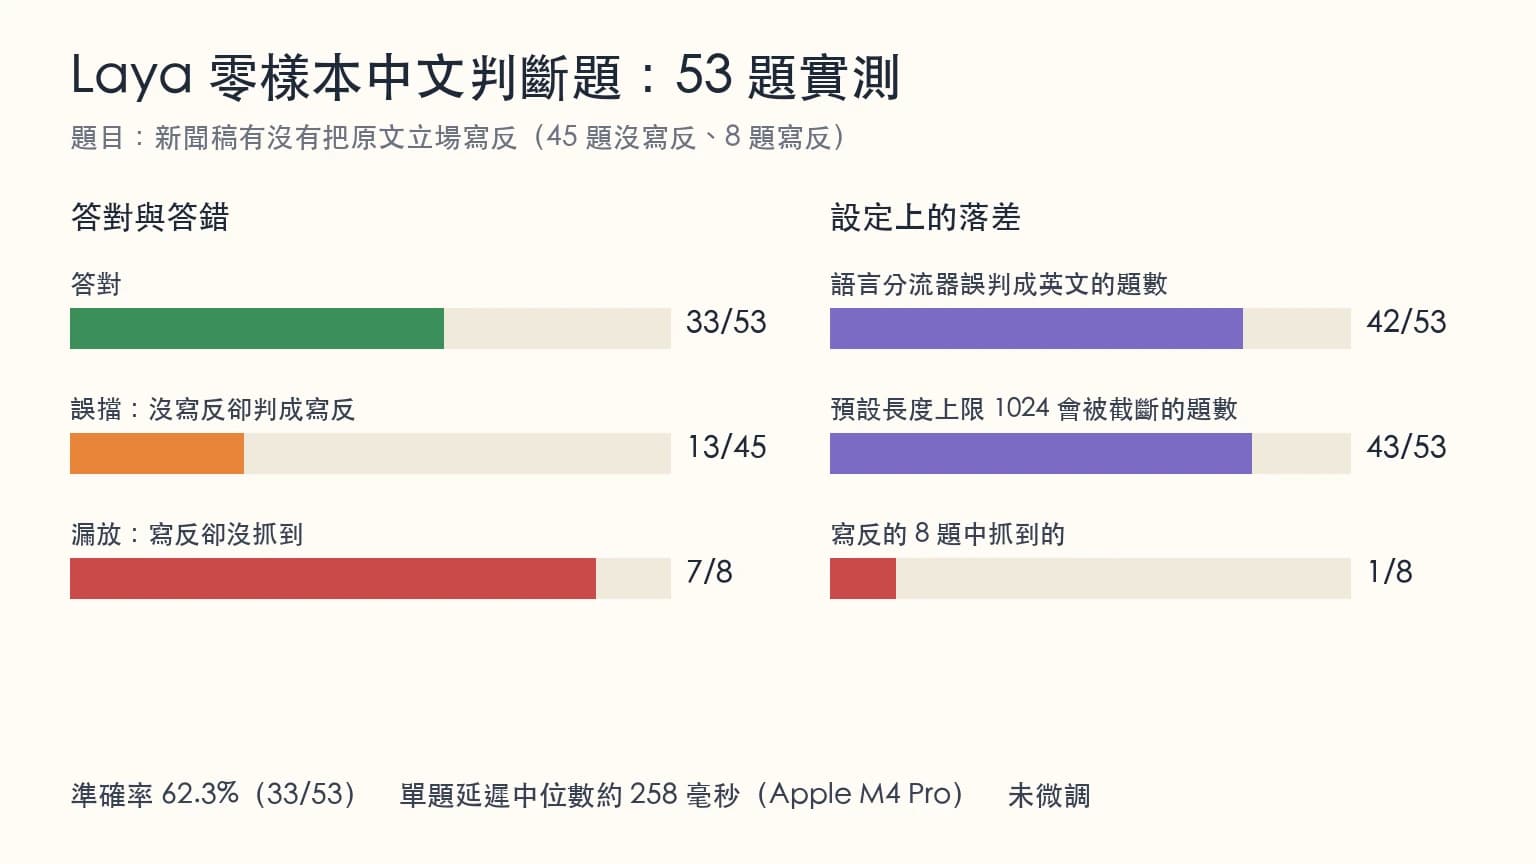
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。