安全倫理
模型內部邏輯值洩露了什麼?Vision-Language 模型的資訊安全風險研究
What do your logits know? (The answer may surprise you!)
arXiv cs.AI · 2026-04-14
摘要
研究團隊系統性地測試了 Vision-Language 模型在不同「表示層級」中保留的資訊,發現即使是容易獲取的輸出層 top-k logits 值,也可能洩露圖像查詢中的無關任務資訊,洩露程度有時甚至與直接讀取完整 residual stream 一樣嚴重。這項發現揭示了模型所有者在保護用戶隱私時低估的資訊洩露風險。
研究團隊以 Vision-Language 模型為測試平台,首次系統性地比較了資訊在不同「表示層級」(representational levels)中被壓縮後所保留的程度。研究指出,模型內部包含的資訊量遠超其最終生成內容,這可能導致非自願或惡意的資訊洩露,使模型使用者獲取了模型擁有者原本認為無法取得的資訊。
研究分析了資訊從殘餘流(residual stream)經過兩個自然瓶頸壓縮的過程:一是透過調整後的透鏡(tuned lens)獲得的殘餘流低維度投影,二是最終可能影響模型回答的 top-k logits。結果顯示,即使是容易獲取的由 top logit 值定義的瓶頸,也可能洩露圖像查詢中存在的無關任務資訊。在某些情況下,這種洩露程度與直接投影完整殘餘流所揭示的資訊量一樣多。
這項發現揭示了模型所有者在保護用戶隱私時,可能低估了模型內部邏輯值洩露的風險。研究強調,即使是模型輸出層中看似安全的 top-k logits 值,也並非完全安全,其洩露的資訊量有時與直接讀取模型內部完整狀態相當。
●開發者:需要重新評估 logits 訪問權限與隱私邊界設計
●投資人:AI 安全與隱私防護成為必要的投資領域
●一般用戶:模型的輸出結果可能比預期暴露更多個人資訊
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →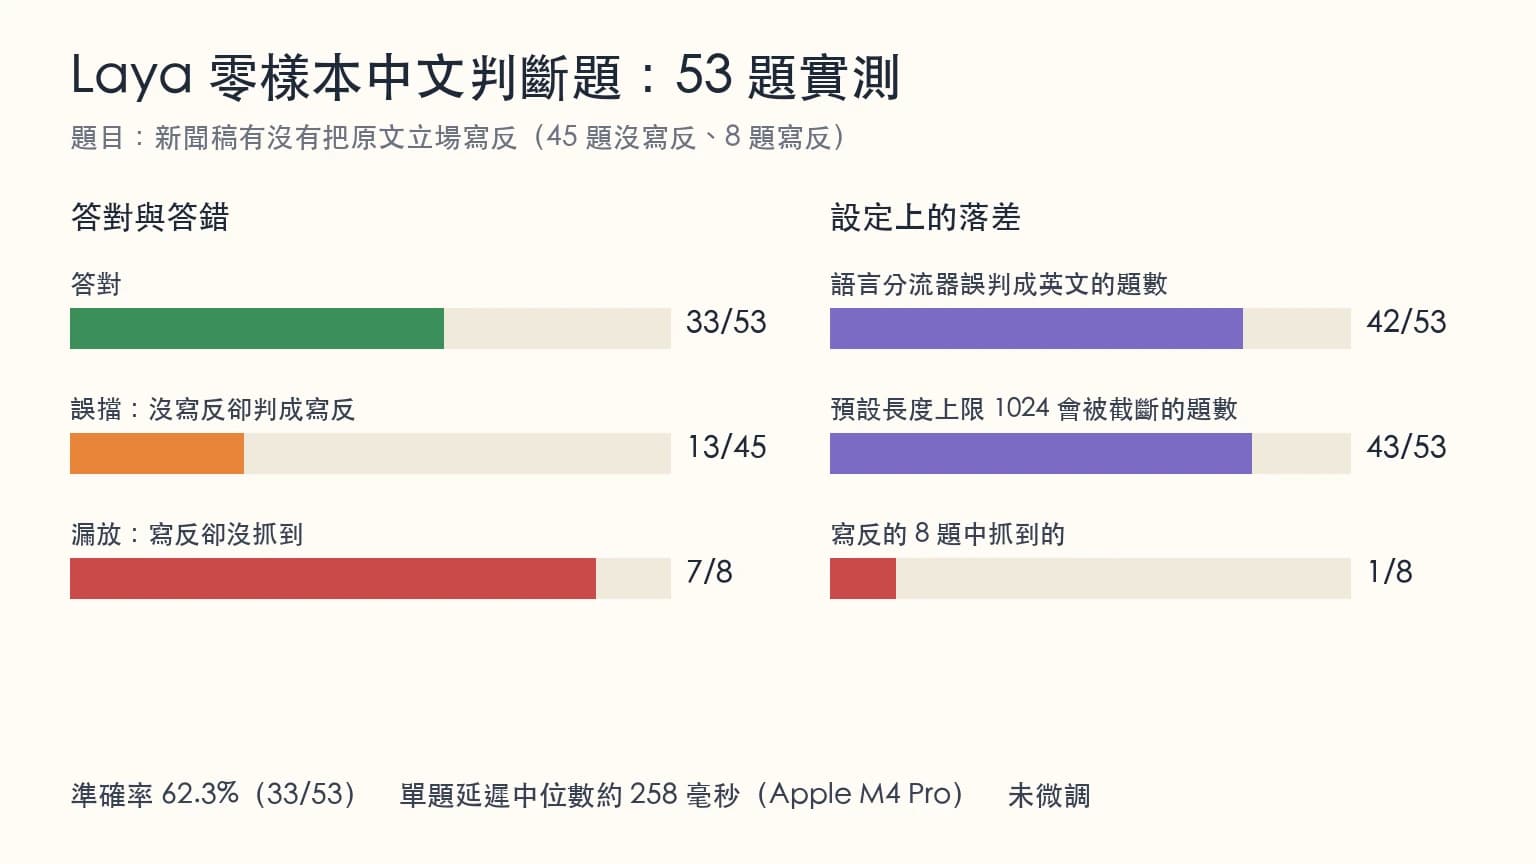
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。