安全倫理
敘述勝於數據:大型語言模型中的「可識別受害者效應」及其在對齊與推理下的放大
Narrative over Numbers: The Identifiable Victim Effect and its Amplification Under Alignment and Reasoning in Large Language Models

arXiv cs.CL · 2026-04-15
摘要
研究人員首次系統性調查大型語言模型(LLMs)是否會重現人類道德推理中的「可識別受害者效應」——即傾向於幫助具體敘述的個體勝於統計數據描述的群體。該研究涵蓋 Google、Anthropic、OpenAI、Meta 等 9 個組織的 16 個前沿模型,共進行 51,955 次 API 試驗,發現 LLMs 確實會出現這種認知偏誤,且在對齊與推理能力增強後反而更加顯著,這對於人道主義分類、補助評估和內容審核等應用場景有重要啟示。
研究人員首次對大型語言模型(LLMs)進行系統性大規模實證調查,探討其是否重現人類道德推理中的「可識別受害者效應」(Identifiable Victim Effect, IVE)。該效應指將更多資源分配給具體敘述的個體,而非面臨同等困境的統計群體。研究涵蓋 Google、Anthropic、OpenAI、Meta、DeepSeek、xAI、Alibaba、IBM 及 Moonshot 等九個組織的 16 個前沿模型,共執行 51,955 次驗證過的 API 試驗。
研究團隊採用源自 Small et al. (2007) 與 Kogut and Ritov (2005) 的十項實驗範式,發現 IVE 在大型語言模型中普遍存在,但受到對齊訓練的強烈調節。接受指令微調的模型展現極端 IVE,Cohen's d 值高達 1.56;而專精於推理的模型則反轉該效應,d 值低至 -0.85。整體 pooled 效應(d=0.223, p=2e-6)約為 Lee and Feeley (2016) 報告的單個受害者人類元分析基線(d≈0.10)的兩倍。
標準思維鏈(Chain-of-Thought, CoT)提示在研究中扮演了與預期相反的角色,幾乎將 IVE 效應量從 d=0.15 提升至 d=0.41,即增加近三倍;唯有功利主義 CoT 能可靠地消除該效應。研究同時記錄了心理麻木、數量完全忽視以及邊際的群內/群外文化偏見,這些發現對人道主義決策與內容審核等應用場景具有直接啟示。
●開發者:需重視模型在道德決策場景中的隱性偏誤,設計時應考慮對抗此類認知扭曲
●投資人:LLMs 在高風險決策領域(如資源分配、審核)的可靠性存疑,相關垂直應用需更謹慎評估
●一般用戶:LLM 驅動的助赈應用、審核系統可能因敘述框架而做出不公平決定,應提高警覺
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Google AI Studio Vibe Coding 教學:快速原型開發實戰
深入解析 Vibe Coding 是什麼,並提供 Google AI Studio 使用教學。透過 Google 程式碼生成技術,快速建立原型,提升開發效率。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →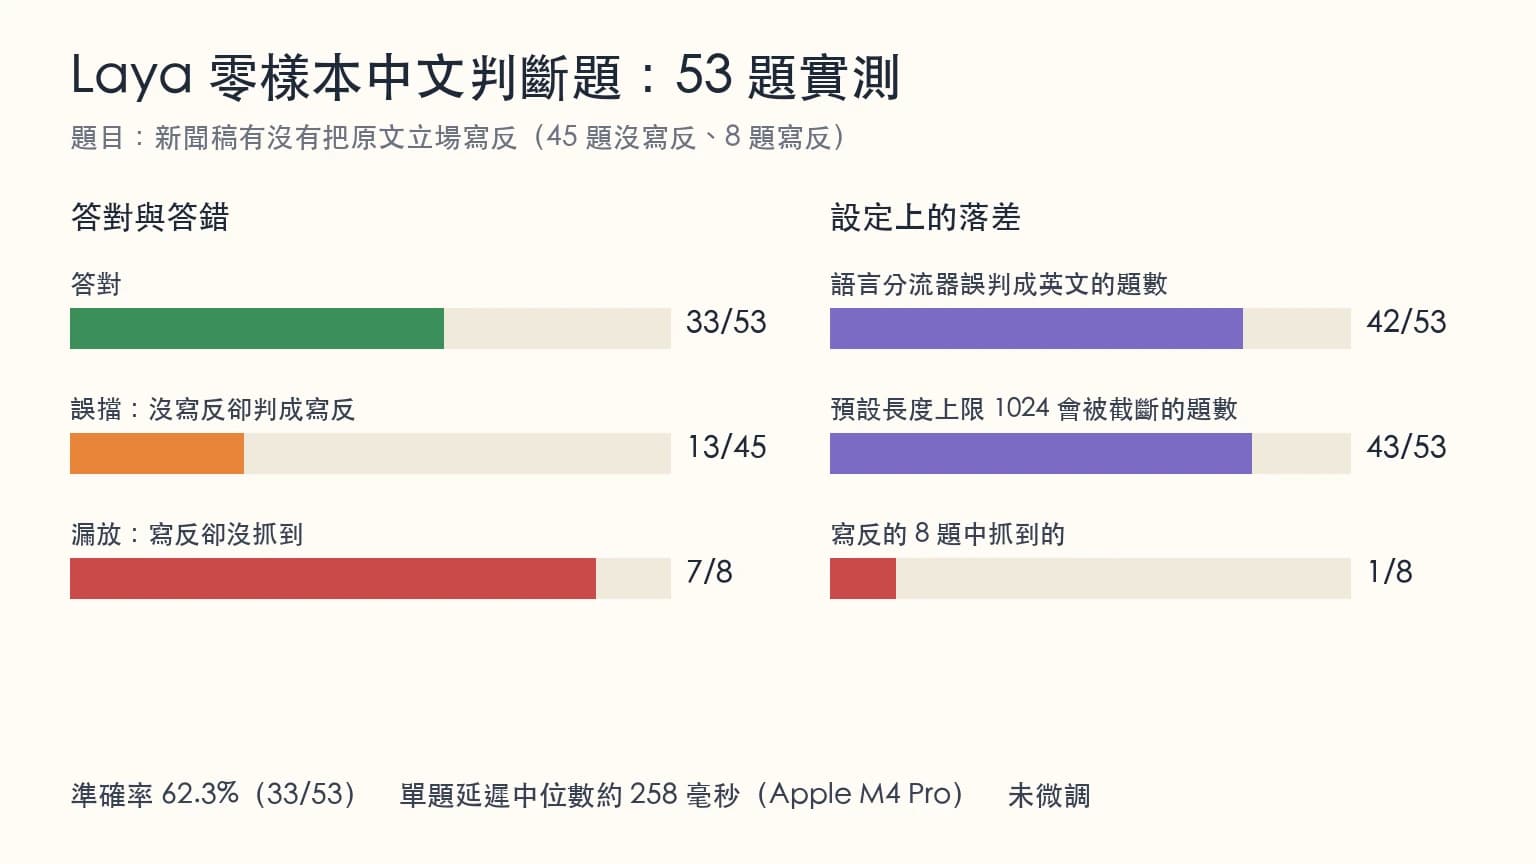
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。