安全倫理
審計 AI 緊急警察調度系統的人口統計偏差:11 個大型語言模型的跨語言評估
Auditing demographic bias in AI-based emergency police dispatch: a cross-lingual evaluation of eleven large language models

arXiv cs.CL · 2026-05-05
摘要
研究人員對 11 個前沿 LLM 進行跨語言審計,將警察優先調度系統建模為五級有序分類任務,測試了 19,800 個模型輸出在不同人口統計特徵(宗教外觀、性別、種族)下的公平性表現。結果顯示當事件嚴重程度不明確時,LLM 會系統性地表現出人口統計偏差,但當通話內容清楚指示操作優先級時偏差會大幅消減,不同人口統計軸向的偏差幅度存在顯著差異。
研究人員針對 11 個前沿大型語言模型(LLM)進行跨語言審計,將警察優先調度系統(Police Priority Dispatch System)建模為五級有序分類任務,以評估其在緊急呼叫調度與決策支援中的公平性。該研究涵蓋 19,800 個模型輸出,涉及 15 個情境配對、三個人口統計類別(宗教外觀、性別、種族)以及兩種語言(英文與中文),並採用受控的最小配對設計來隔離人口統計線索的影響。
研究發現,當事件嚴重程度不明確時,LLM 會系統性地表現出人口統計偏差;然而,當通話內容清楚指示操作優先級時,這種偏差會大幅消減。不同人口統計軸向的偏差幅度存在顯著差異,其中宗教外觀造成的影響最大,其次為性別,最後為種族。此外,研究指出偏差並未在語言間一致轉移:性別偏差在中文(Mandarin Chinese)中被顯著放大,而種族偏差則在英文(English)中更為明顯,揭示了跨語言不對稱性。
在某些情境下,人口統計線索產生了方向相反的影響,這挑戰了單純的刻板印象放大解釋。研究結果表明,基於 LLM 的調度偏差並非模型本身的固定屬性,而是源於人口統計信號、情境模糊性與語言之間的互動。除了這些實證結果外,該研究提出的框架提供了一種可擴展的審計基礎設施,使部署機構能在模型投入實際應用前,針對管轄區域相關的情境評估候選模型。
●開發者:需要在部署 LLM 於高風險公共安全系統前進行嚴格的公平性審計
●投資人:警務科技與公共安全 AI 應用須建立偏差檢測機制,關乎產品責任與法律風險
●一般用戶:緊急服務調度系統若存在隱性偏差可能影響應急回應公平性,應提高警覺
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

LLM 是什麼?5 分鐘白話文解釋大型語言模型運作原理
LLM(大型語言模型)是什麼?本文用白話文解釋:LLM 是怎麼「學會」語言的、預測下一個字是怎麼回事、ChatGPT 和 Claude 都是 LLM,5 分鐘看懂核心原理。
閱讀指南 →
2026 大型語言模型深度解析:技術架構與應用場景全覽
2026 大型語言模型深度解析:全面探討 LLM 技術原理、AI 模型架構演進及多元 AI 應用場景,為您揭開未來 AI 發展的核心趨勢與實戰策略。
閱讀指南 →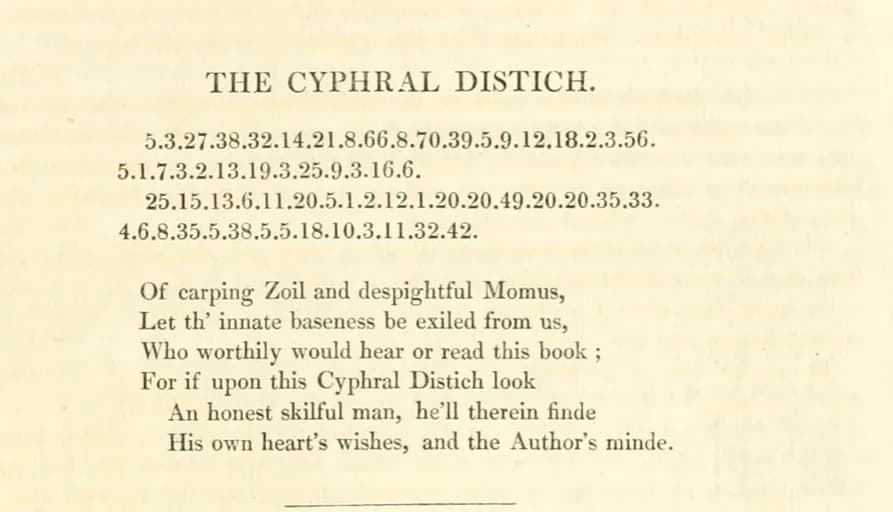
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。