安全倫理
注意力就是攻擊點:Attention Redistribution Attack 破解安全對齊 LLM
Attention Is Where You Attack

arXiv cs.AI · 2026-05-05
摘要
研究人員發現了一種名為 Attention Redistribution Attack(ARA)的新型對抗性攻擊方法,能透過識別安全關鍵的注意力頭,並使用非語義對抗性符號將模型的注意力從安全相關位置轉移,從而繞過 LLaMA、Mistral 和 Gemma 等主流模型的安全對齐機制。該方法僅需 5 個符號和 500 步優化即可達成 30-36% 的攻擊成功率,揭示了當前安全對齊方案在機制層面的根本脆弱性。
研究人員提出了一種名為 Attention Redistribution Attack(ARA)的新型白盒對抗性攻擊方法,旨在破解依賴 RLHF 和指令微調來拒絕有害請求的大型語言模型的安全對齊機制。與以往在語義層或輸出 Logit 層運作的越獄方法不同,ARA 專注於攻擊 Softmax 注意力在概率單形上的幾何結構,透過 Gumbel-softmax 優化針對特定注意力頭,識別出安全關鍵的注意力頭,並生成非語義對抗性符號將模型注意力從安全相關位置轉移。
在 LLaMA-3-8B-Instruct、Mistral-7B-Instruct-v0.1 和 Gemma-2-9B-it 等主流模型上的測試顯示,該方法僅需 5 個符號和 500 步優化即可達成攻擊。針對 HarmBench 的 200 個提示,ARA 在 Mistral-7B 上達到了 36% 的攻擊成功率(ASR),在 LLaMA-3 上達到 30%,而 Gemma-2 則維持在 1%。這揭示了當前安全對齊方案在機制層面存在根本脆弱性。
研究發現安全機制並非簡單地定位於可被移除的特定頭部。當將排名最高的安全頭部歸零(ablation)時,在 39 到 50 個基準拒絕中最多僅產生 1 次翻轉;然而,當 ARA 針對相應的安全密集層級進行注意力重定向時,在 Mistral-7B 上成功翻轉了 72/200 個提示,在 LLaMA-3 上成功翻轉了 60/200 個提示。這表明安全並非存在於可移除的組件中,而是源自這些頭部所執行的注意力路由,移除頭部可透過殘餘流(residual stream)進行補償,但重定向其注意力則會傳播腐蝕信號至下游。
●開發者:需要重新審視 RLHF 和指令調優的安全防禦設計,探索更深層的機制級防護方案
●投資人:LLM 安全防禦成為新的技術競爭點,相關防禦技術和安全審計服務具有商業價值
●一般用戶:現有安全對齐可能比預期更容易被繞過,用戶需更謹慎地使用可能被惡意利用的模型
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

Internal Safety Collapse 是什麼?揭開 AI 模型越強大越危險的 95.3% 失敗率真相
深入解析 Internal Safety Collapse (ISC) 是什麼?探討為何 AI 模型越強大越容易崩潰,揭露 95.3% 的失敗率數據,以及對 AI 模型安全性的具體影響與未來挑戰。
閱讀指南 →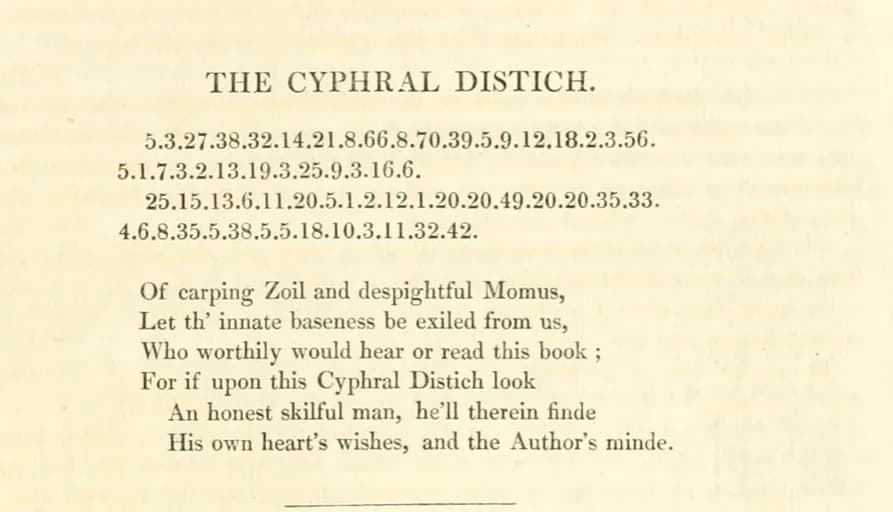
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。