研究突破
擲硬幣的法官?LLM-as-a-Judge 評估的可靠性與偏差研究
The Coin Flip Judge? Reliability and Bias in LLM-as-a-Judge Evaluation

arXiv cs.AI · 2026-06-15
摘要
研究發現 LLM 擔任評判角色時存在嚴重的可靠性問題:在 29 項任務的重複評估中,GPT-4o-mini 和 GPT-4.1-mini 的配對偏好平均翻轉率達 13.6%,最高甚至達 56%。GPT-4o-mini 還出現明顯的位置偏差(傾向選擇首位選項達 72%),這對廣泛應用於排名模型、訓練獎勵模型和公開排行榜的 LLM 評判系統提出了重大質疑。
研究針對目前廣泛用於模型排名、獎勵模型訓練及公開排行榜的 LLM-as-a-Judge 機制,探討其運行間可靠性的不足。研究團隊利用 OpenAI 的 GPT-4o-mini 與 GPT-4.1-mini 兩個評判模型,在涵蓋 10 個類別的 29 項任務上進行重複評估,每題包含 50 次配對試驗(pairwise trials)與 50 次點數試驗(pointwise trials),並補充了溫度與提示敏感性消融實驗。
數據顯示,跨評判模型的配對偏好平均翻轉率達 13.6%,其中 28% 的問題翻轉率高於 20%,單一問題甚至高達 56%。此外,GPT-4o-mini 表現出顯著的首位位置偏差,在 A-majority 情境下選擇首位選項的比例達 72%(p = 0.024)。
儘管配對結果存在高翻轉率,但平均點數分數差距極小,介於 10 分制中的 0.19 至 0.36 分之間,且整體上未達統計顯著性。這導致了配對與點數之間的巨大落差:評判模型經常在自身標量分數缺乏有意義證據的情況下,強行選出獲勝者。
●開發者:需警惕在生產系統中過度依賴 LLM 評判的可靠性,建議採用多判官或人類驗證機制
●投資人:LLM 評估工具存在應用侷限,相關評分體系的商業價值需重新評估
●一般用戶:公開排行榜的排名可能不如預期可信,應警惕基於 LLM 評判生成的榜單
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
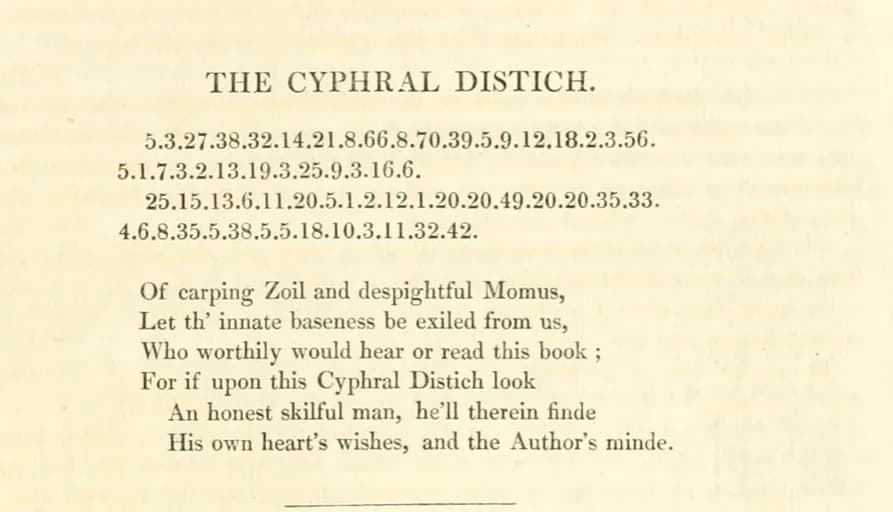
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →
TypeSafe 的 Jev 是什麼:不會寫文章、只做判斷的「System One」模型,對開發者與小團隊的意義
TypeSafe AI 推出的 Jev 不寫文章、不生成文字,只做「從固定選項裡挑一個」的判斷——我們核對官方 blog 與文件原文,把速度、價格、「不會幻覺」這句話的真正意思,以及對小團隊的實際用法,一次講清楚。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。