研究突破
共享嵌入序列模型中指令與資料的不可分性
On the Inseparability of Instructions and Data in Shared-Embedding Sequence Models

arXiv cs.AI · 2026-06-29
摘要
研究證明在共享嵌入架構的大語言模型中,完美的提示注入防禦在數學上不可能實現。這是因為信任內容與不信任內容在統計層面無法區分,使得任何基於編碼方式的防禦都會失效。這項發現對 LLM 應用的安全設計具有根本性意義,意味著未來防禦方案需要從架構層面進行改革,而非在現有框架內尋求補救。
提示注入是整合大型語言模型應用的首要安全風險,然而目前提出的所有防禦措施均已被破解。研究證明,在缺乏強制控制與數據分離的共享嵌入架構中,實現完美的提示注入防禦在數學上是不可能的。這並非偶然,而是因為信任內容與不信任內容在統計層面上無法區分,導致任何基於編碼方式的防禦都會失效。
研究將提示系統形式化為「提示行動模型」,其輸出包含控制權威性行動,如拒絕決策、工具授權、政策路由和記憶體寫入。研究定義了「語義忠實控制」,即此類行為僅取決於未信任輸入的含義,而非其編碼方式。研究透過三個結果證明,在共享管道中無法實現語義忠實控制:一是「來源恢復不可能性」,共享表示使信任與未信任內容在統計上不可區分,其差異受限於總變異距離;二是「控制路徑暴露」,未信任令牌透過決定輸出的相同注意力值聚合進入控制相關計算;三是「有限覆蓋不變性差距」,有限的訓練無法證明對無限語義等價類別的不變性。
這些結果在生產環境的詞彙表和模型測量中得到了具體數據的支撐,表明這是結構性問題,而非現有防禦措施的缺陷。這一發現反映了馮·諾依曼機器中代碼與數據混淆所導致的緩衝區溢出問題,這類漏洞花了數十年的時間,透過層層防禦(如 DEP、Write-XOR-Execute、ASLR、堆棧緩衝區檢查,以及最終的記憶體安全語言)才得以控制,因為單一機制無效。
結論指出,提示注入無法僅透過改進管道內的分類或對齊來消除。解決方案需要從架構層面進行改革,實現指令與數據通道的分離,而非在現有框架內尋求補救。研究已識別出根本原因及其所要求的解決方案類別。
●開發者:需要重新思考 LLM 應用的安全架構設計,考慮控制資料分離的新範式
●投資人:提示注入防禦的永久性難題將推動新一代安全基礎設施和工具的投資機會
●一般用戶:提醒當前 LLM 應用存在根本性安全局限,應審慎信任敏感場景的 LLM 決策
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
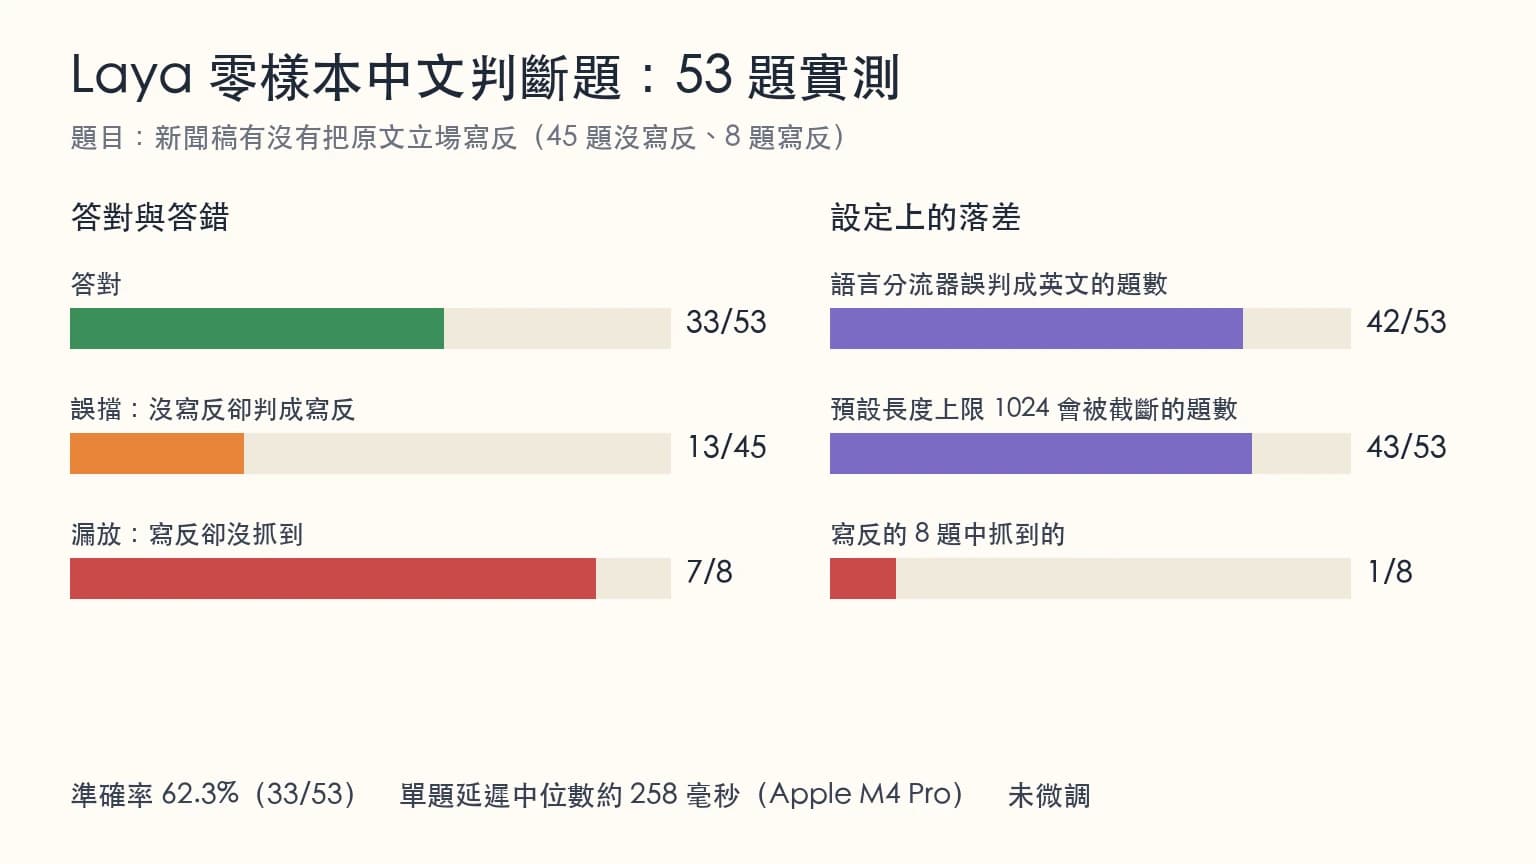
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →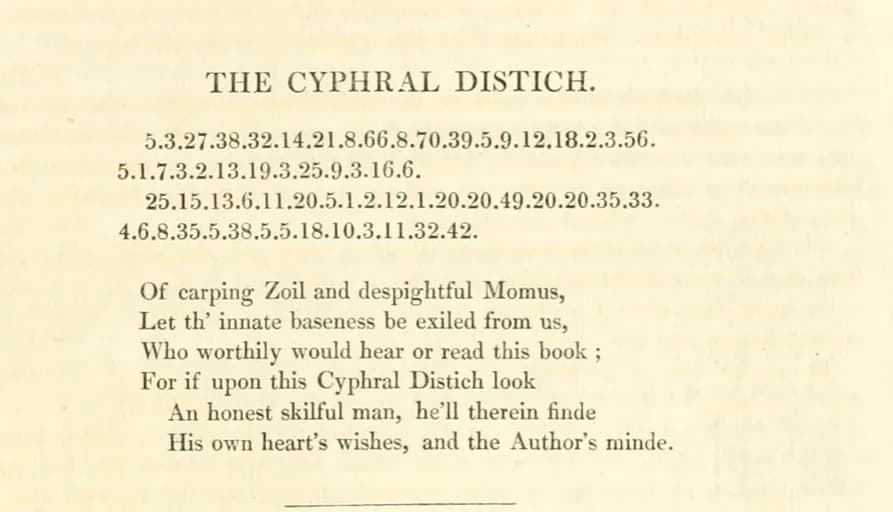
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。