垂直產業
臨床 AI 工具在真實臨床查詢中的專家評估
Expert Evaluation of Clinical AI Tools on Real Point-of-Care Clinical Queries

arXiv cs.AI · 2026-06-30
摘要
研究人員對三款通用 AI 模型(Claude Opus 4.8、Gemini 3.1 Pro、GPT-5.5)和專科臨床工具進行了盲測對比,使用來自 30 個醫療專科的 620 個真實臨床查詢。149 位執業醫師評估發現,專科臨床工具在準確性、臨床實用性、資訊品質、可驗證性和完整性等五個維度上都優於通用 AI 模型,證明專為醫療場景設計的 AI 工具更適合實際臨床決策支援。
研究指出,目前醫師每週向 AI 工具提出數百萬個臨床問題,但這些工具的評估大多基於假設性或考試風格的問題,而非實際臨床場景中的真實查詢。為解決此落差,研究團隊針對 620 個來自 OpenEvidence (OE) 平台的真實點對點臨床查詢(Real-POCQi)以及 187 個來自 HealthBench 的問題,進行了盲測評估。參與評估的對象涵蓋 36 個州的 149 位執業醫師,他們針對來自 30 個醫療專科的問題,將三款前沿通用模型(Claude Opus 4.8、Gemini 3.1 Pro 和 GPT-5.5)與專科臨床工具 OE 進行直接對比,且評分者均與問題所屬專科相匹配。
在準確性、臨床實用性、資訊來源品質、可驗證性以及完整性這五個與臨床決策支援相關的維度上,醫師們對專科臨床工具 OE 的評分在所有軸線上均高於通用 AI 模型。在針對 Real-POCQi 的主要分析中,勝率與敗率之間的差距(win differences)介於 25 至 39 個百分點之間,且統計顯著性達到 p<0.001。即使在根據引用顯示、答案長度、OE 使用者身份以及 Real-POCQi 與 HealthBench 進行分層敏感性分析後,結果仍保持一致。
研究同時發現,大型語言模型(LLM)評審與專家評審在判斷上存在系統性差異,儘管雙方通常對最佳模型達成共識。研究強調兩個結論:第一,AI 工具的評估應反映真實世界的查詢分佈,並使用能反映現代醫學專業化的專家評審;第二,專科工具相對於通用模型的優勢,並不意味著通用模型無法發揮類似作用,而是表明針對性的工程設計與客製化能為用戶帶來有意義的效能提升。研究團隊已將 Real-POCQi 作為公開基準發布,並公開了預先規定的統計分析以重現研究結果。
●開發者:需要針對臨床特定場景優化 AI 模型,而非依賴通用大模型
●投資人:醫療 AI 垂直化應用前景看好,專科工具相比通用模型更有競爭力
●一般用戶:未來就診時醫師所用的 AI 輔助工具將更加準確可靠
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
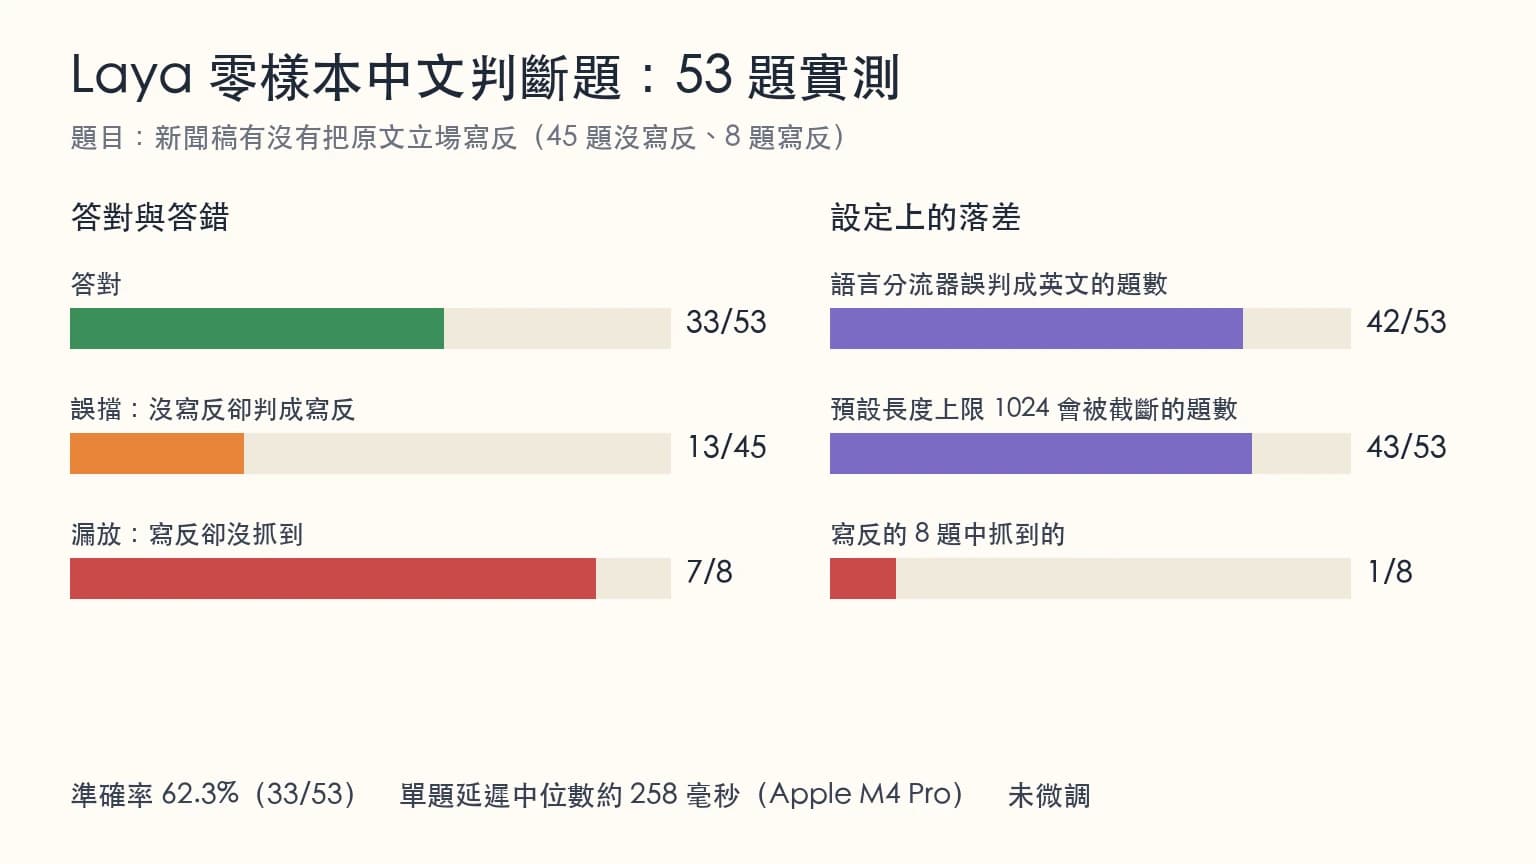
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →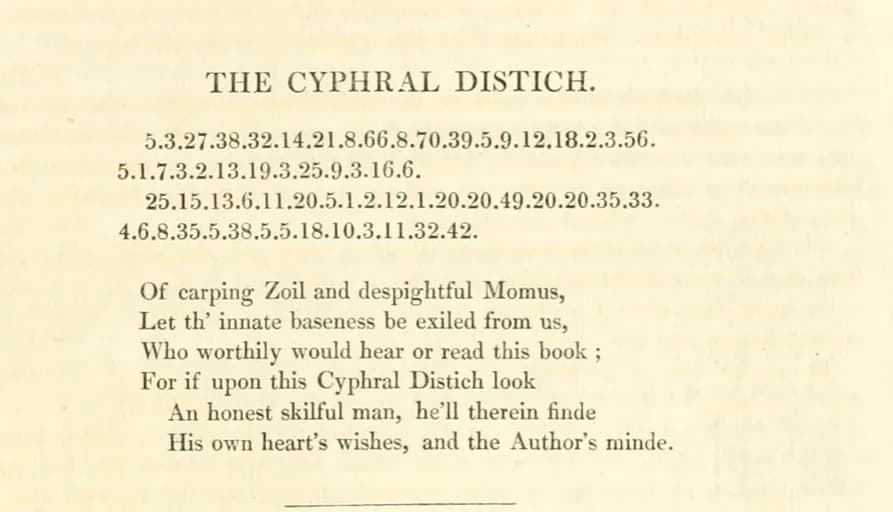
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →
ChatGPT 小型企業工具集(Small Business Collection):16 個官方工具怎麼用、台灣店家該注意什麼
OpenAI 官方 ChatGPT 小型企業工具集共 16 個外掛,我們逐一核對官方目錄頁與工具詳情頁,整理成台灣店家看得懂的用法與注意事項——包含最容易被忽略的 Mercury 銀行外掛,以及方案、地區限制官方沒有講清楚的地方。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。