研究突破
IsoSci:用同構跨域科學問題基準測試 LLM 的推理能力與知識檢索
IsoSci: A Benchmark of Isomorphic Cross-Domain Science Problems for Evaluating Reasoning versus Knowledge Retrieval in LLMs

arXiv cs.CL · 2026-07-03
摘要
研究團隊推出 IsoSci 基準測試,透過設計邏輯結構相同但需要不同領域知識的問題對,精確分離 LLM 的推理能力和領域知識檢索。研究發現超過 91% 的推理模式改進來自知識依賴而非結構不變性,直接挑戰了「chain-of-thought 推理能改善科學問題解題」的假設,並揭示專門推理模型在某些基準上反而表現更差。
●開發者:應重新評估推理模式的實際效益,調整提示工程策略
●投資人:需審視推理能力聲稱,警惕過度宣傳的模型性能差異
●一般用戶:AI 助手的科學問題解答品質可能受限於知識而非推理能力
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南

【深度解析】ARC-AGI 到底是什麼?為什麼刷高分不代表 AI 會推理?
深入解析 ARC-AGI 測試原理,揭開其設計邏輯與傳統 AI 測試的差異。為什麼高分不代表通用智能?本文帶你理解 ARC 代理挑戰的核心機制與未來挑戰。
閱讀指南 →
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →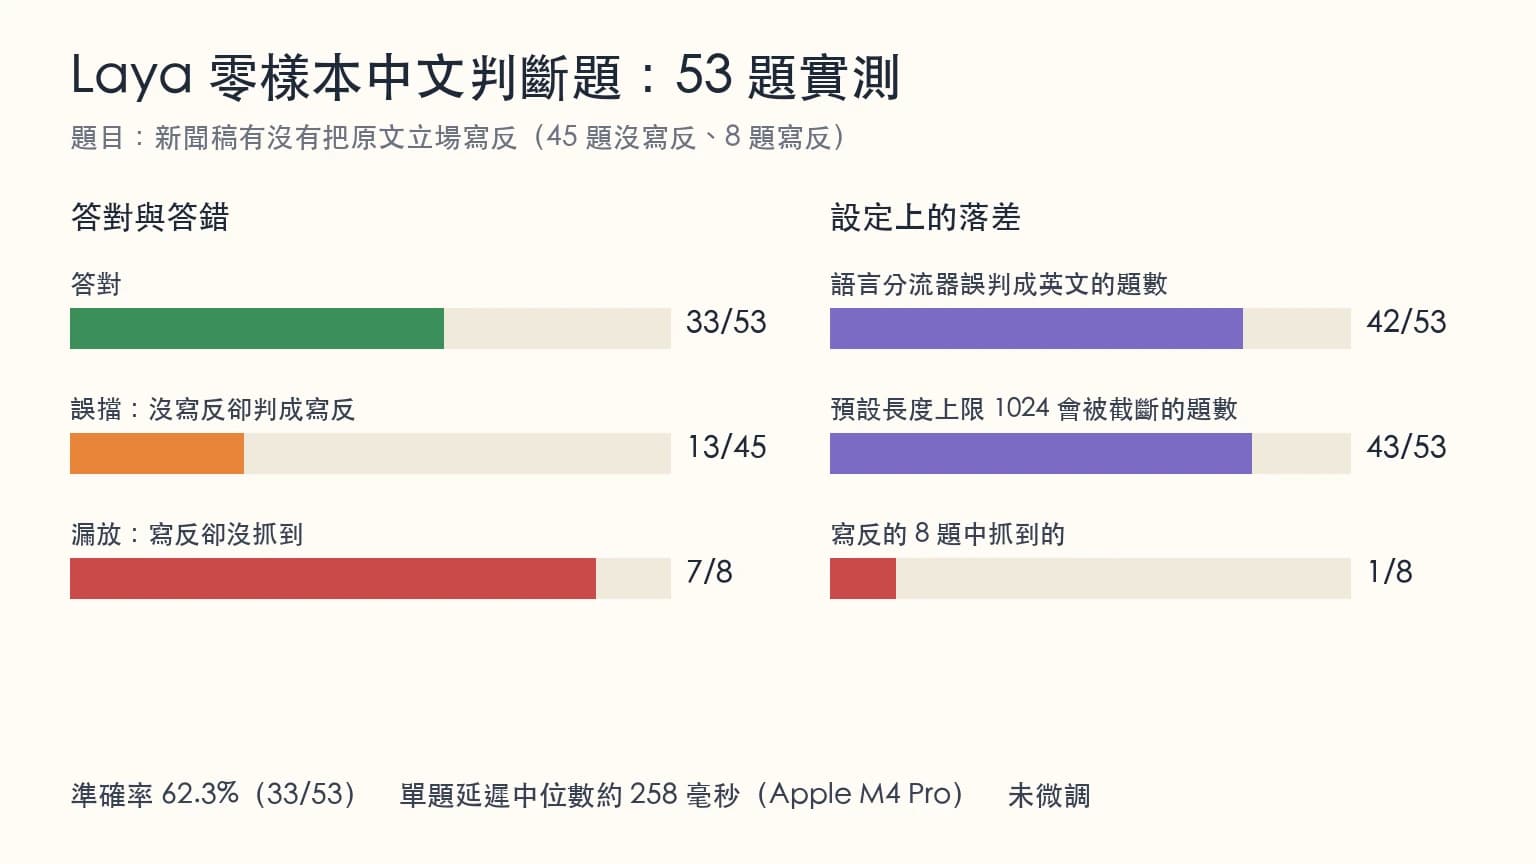
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。