研究突破
Vera:大規模LLM agents安全測試框架,從風險發現到驗證
Safety Testing LLM Agents at Scale: From Risk Discovery to Evidence-Grounded Verification

arXiv cs.AI · 2026-07-03
摘要
研究團隊推出Vera框架,專門用於測試LLM agents在使用外部工具時的安全風險。該框架透過三階段自強化流程,自動發現新興安全風險、構建風險分類,再組合生成可執行的安全測試案例,並透過可驗證的規則進行評估,大幅降低測試成本並適應不斷演進的agent系統。
LLM agents 透過外部工具執行自主行動,導致安全風險日益複雜且不斷演變。現有安全測試方法依賴專家設計的違規情境,並以硬編碼規則評估結果,隨著 agent 系統演進而難以擴展且成本高昂。針對此問題,研究團隊提出 Vera,一個將軟體工程測試原則應用於非確定性 agent 的端到端自動化安全測試框架。
Vera 透過三階段自強化流程運作:第一階段透過文獻驅動探索,持續發現並將新興風險結構化為安全風險、攻擊方法與工具執行環境的分類體系;第二階段在分類體系各維度間進行組合構建,生成可執行的安全測試案例,每個案例包含具體安全目標、程式化構建的初始狀態,以及基於可觀察 artifacts 的確定性驗證條件;第三階段進行適應性執行,在隔離沙盒中運行異質 agent,由控制 agent 根據運行時觀察結果引導多輪互動,而基於證據的驗證器則從環境狀態與工具呼叫證據而非模型自我報告來判斷結果。
研究團隊在四個生產環境的 agent 框架(OpenClaw, Hermes, Codex, Claude Code)上評估 Vera,發現顯著的安全弱點,在多通道攻擊下平均攻擊成功率高達 93.9%。團隊同時發布 Vera-Bench,包含 1600 個可執行安全案例,橫跨 124 個風險類別及三種執行設定。研究結果顯示,模組化且可執行的測試基礎設施對於大規模嚴謹且可維護的 agent 系統安全評估至關重要。
●開發者:獲得更完整的agent安全測試工具和方法論
●投資人:agent應用安全保障技術進展,降低風險投資門檻
●一般用戶:LLM應用的安全性驗證更完善
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →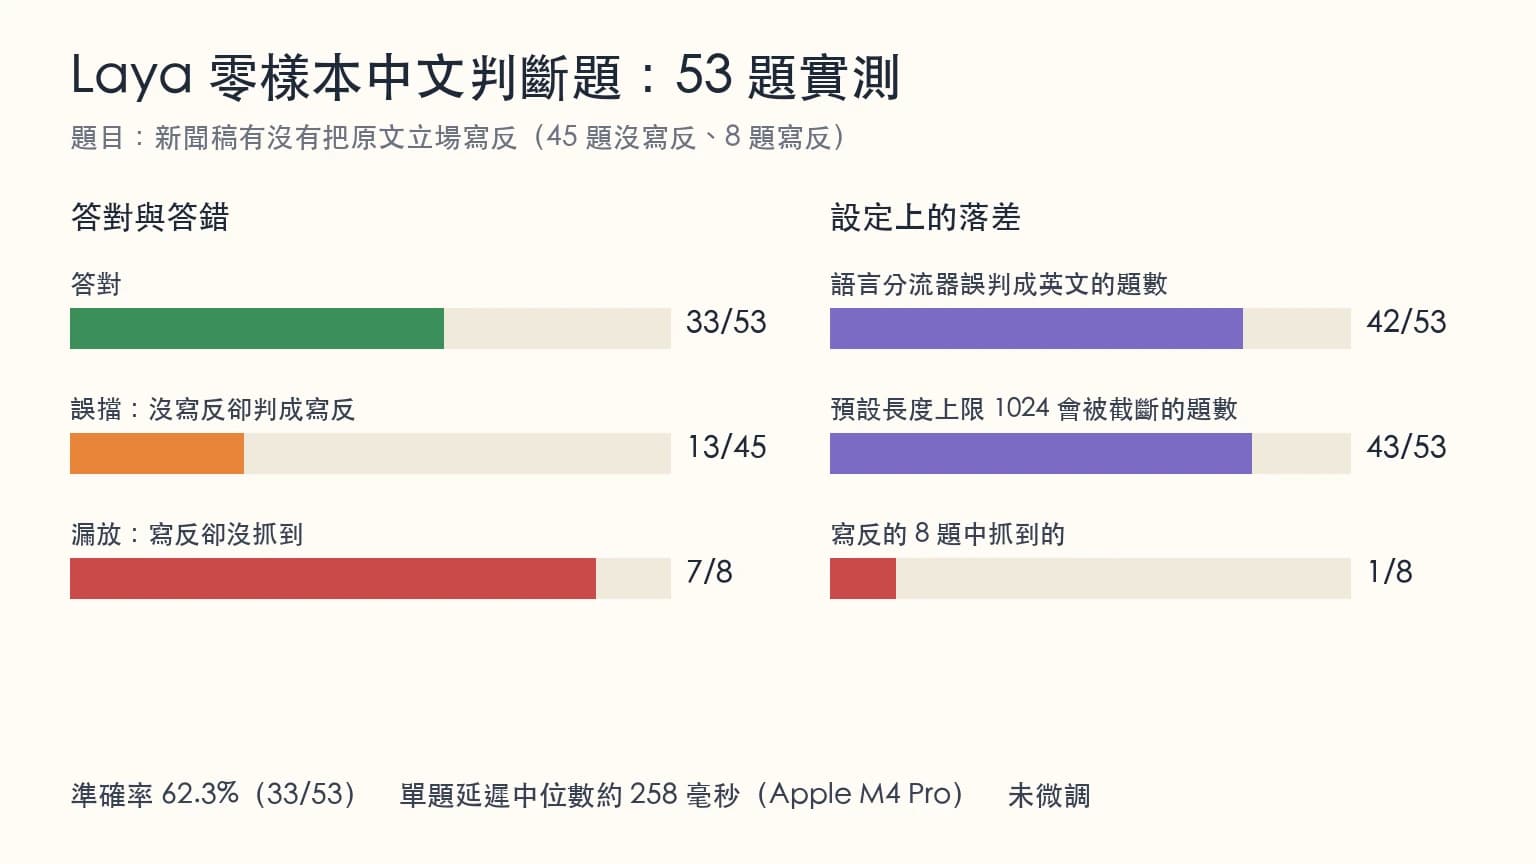
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →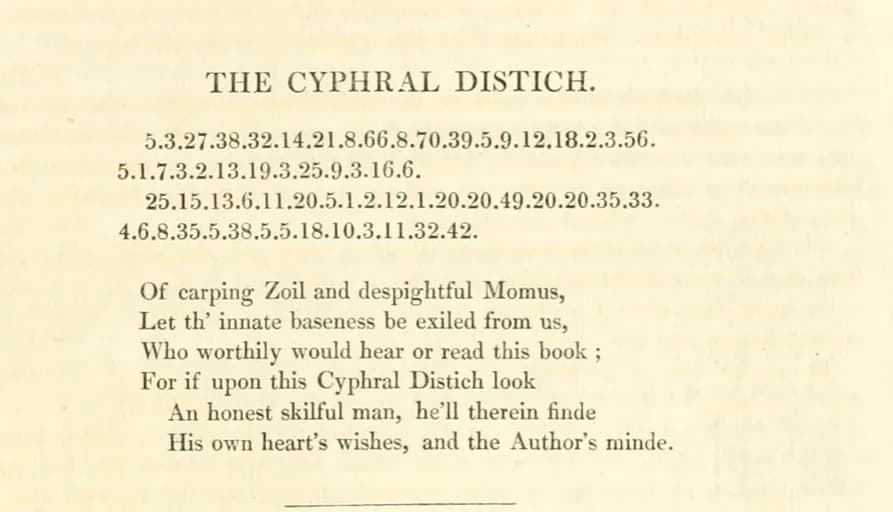
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。