安全倫理
新型攻擊揭示 AI 瀏覽器的危害:LLM 可被簡單欺騙執行禁止命令
New attack provides one more reason why AI browsers are a bad idea

Ars Technica AI · 2026-06-30
摘要
研究人員發現一種新型攻擊方式,只需告訴 LLM 「2+2=5」這類虛假陳述,就足以誘導其遵循原本被設定為禁止的指令。這突顯了 AI 瀏覽器在安全性上的根本漏洞,AI 模型容易被簡單的邏輯欺騙而突破安全防護。
●開發者:需要重新評估 LLM 應用的安全架構與防護機制
●投資人:AI 瀏覽器等消費級應用可能面臨安全風險挑戰
●一般用戶:使用 AI 瀏覽器時應提高警覺,謹慎對待可能被惡用的功能
重要性評分
78/100
🟠 值得關注
LLM 安全提示注入攻擊AI 瀏覽器風險
原文出處喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
perplexity vs chatgpt
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →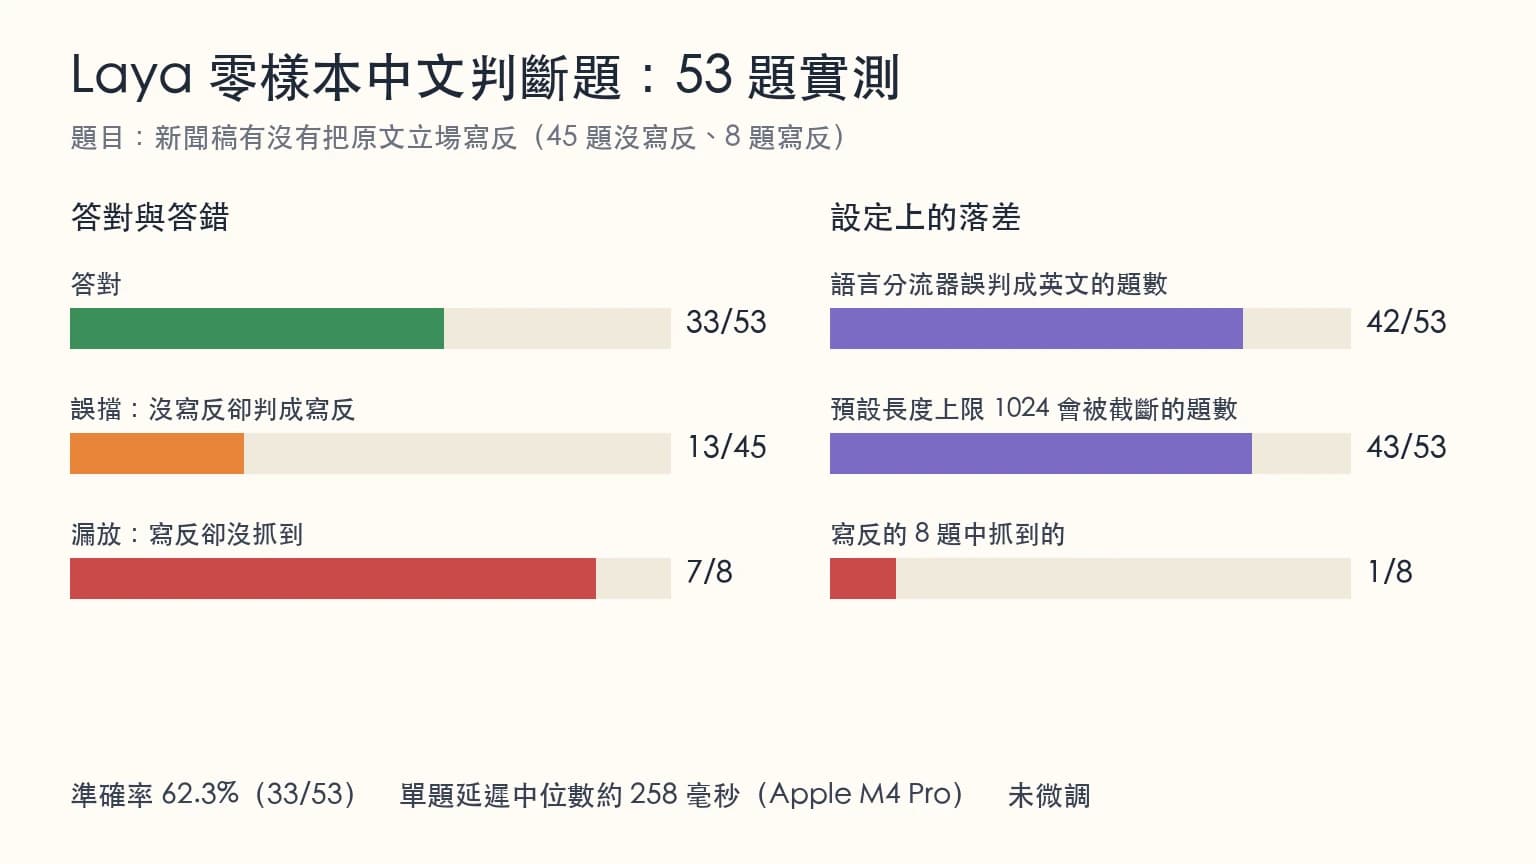
Laya 開源模型
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →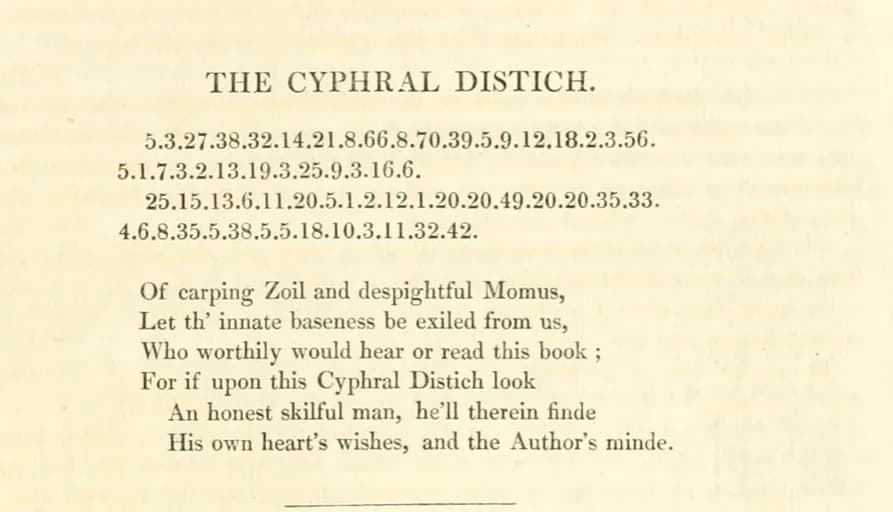
Cyphral Distich
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。