安全倫理
LLMs 與生成式 AI 在資安與隱私中的雙面風險:調查 AI 生成惡意軟體、可解釋性與防禦策略
Large Language Models (LLMs) and Generative AI in Cybersecurity and Privacy: A Survey of Dual-Use Risks, AI-Generated Malware, Explainability, and Defensive Strategies

arXiv cs.CL · 2026-07-09
摘要
這份綜合調查研究 LLMs 和生成式 AI 在網路安全領域的應用,涵蓋防禦與攻擊兩個面向。LLM 生成的惡意軟體從 2021 年的 2% 暴增到 2025 年估計的 50%,催生出新型態的自動化威脅;同時這些技術也能驅動零日漏洞檢測、DevSecOps、聯邦學習等防禦應用,需要建立下一代安全框架應對。
大型語言模型(LLMs)與生成式 AI 系統,包括 ChatGPT、Claude、Gemini、LLaMA、Copilot 以及由 OpenAI、Anthropic、Google、Meta、Microsoft 和 Stability AI 開發的 Stable Diffusion,正在徹底改變網路安全領域。這些技術以前所未有的規模推動了即時威脅偵測、釣魚攻擊防禦、安全程式碼生成以及漏洞利用。
LLM 生成的惡意軟體數量經歷了快速飆升,從 2021 年的 2% 佔比,預計在 2025 年將佔據所偵測威脅的 50%。面對 2026 年高度自動化的威脅環境,必須建立下一代安全框架來應對。
本研究綜合調查了 LLM 在網路安全中有益與惡意的應用,涵蓋零日漏洞偵測、DevSecOps、聯邦學習、合成內容分析以及可解釋性 AI(XAI)。研究基於對超過 70 篇學術論文、產業報告和技術文件的回顧,並整合了來自 Google Play Protect、Microsoft Defender、Amazon Web Services (AWS)、Apple App Store、OpenAI Plugin Stores、Hugging Face Spaces 和 GitHub 等平台的真實案例研究,以及 SAFE Framework 和 AI 驅動異常偵測等新興倡議。
研究結論提出了關於負責任且透明地部署 LLM 以及建立可信 AI 的實際建議,包括模型水印、對抗性防禦和跨產業合作。這為 AI 與威脅防禦交織處的嚴謹、整體性網路安全研究設定新基準,並提供了一條安全、可擴展的 LLM 系統路線圖,作為研究人員、工程師和安全領導者應對 AI 驅動網路安全複雜挑戰的關鍵參考。
●開發者:應學習使用 LLMs 進行安全程式碼生成與威脅檢測,同時警惕 AI 生成惡意軟體的防禦方法
●投資人:資安領域因 AI 威脅升級而面臨新機會與挑戰,防禦工具市場需求大幅提升
●一般用戶:個人裝置面臨更精密的 AI 生成攻擊風險,但同時受惠於更智能的資安防護
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →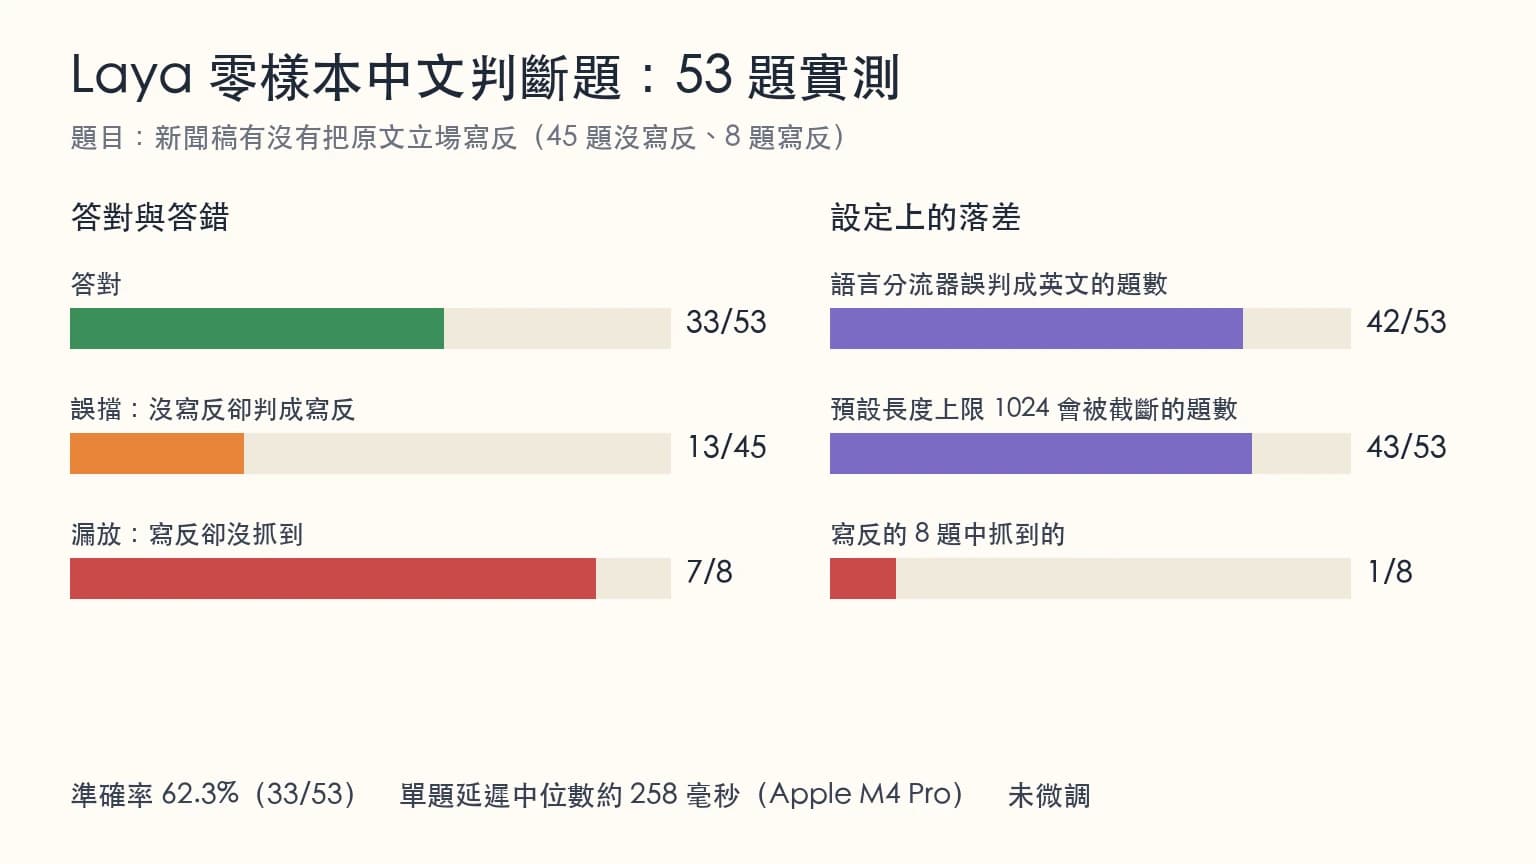
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →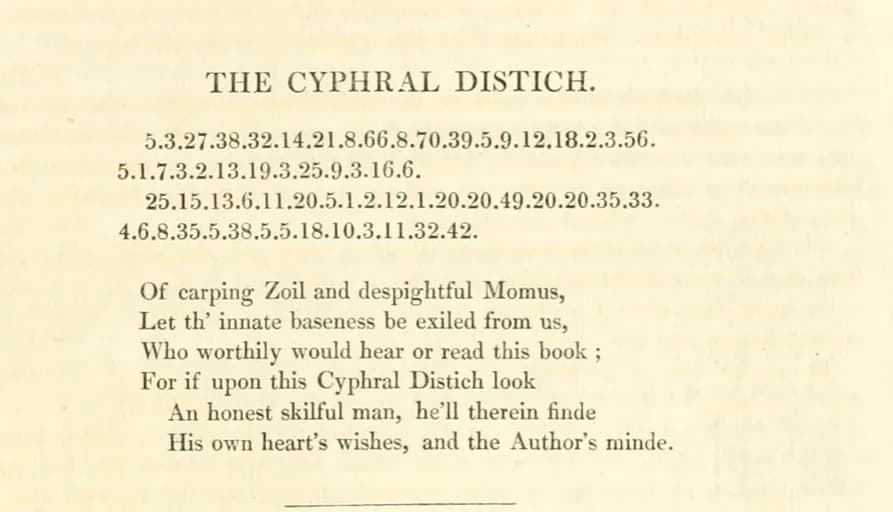
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。