研究突破
UltraX:大規模自適應程序編輯的預訓練數據精煉框架
UltraX: Refining Pre-Training Data at Scale with Adaptive Programmatic Editing

arXiv cs.CL · 2026-07-11
摘要
研究團隊提出 UltraX,一個針對大規模預訓練數據的函數調用精煉框架,突破既有方法的局限。UltraX 整合了刪除、修改和插入三種編輯操作,實現細粒度的實例級數據編輯,既解決了規則型方法的固定啟發式限制,也克服了 LLM 方法的效率和可靠性問題,為數據品質瓶頸時代的 LLM 優化提供新思路。
隨著可用訓練數據逐漸逼近物理極限,Scaling Laws 帶來的增益開始減弱,提升大型語言模型(LLMs)的成效不再依賴數據擴充,而是轉向更高品質的數據利用。然而,現有在大型語料庫中的精煉方法在品質、效率與可靠性上均面臨重大限制:基於規則的方法受固定啟發式限制,難以處理實例級差異;而基於 LLM 的方法雖能提升品質,卻無法滿足大規模數據處理的效率與可靠性需求。
針對上述挑戰,研究團隊提出 UltraX,這是一個針對大規模預訓練數據的函數調用精煉框架。UltraX 透過引入「插入」操作,與既有的刪除和修改操作共同完成編輯功能空間,實現細粒度的實例級數據編輯。該框架建立了一套可靠的程式監督生成流程,首先透過數據適應性提示優化引導專家 LLM 產生高品質的端到端精煉文本,接著利用線對齊映射與動態上下文替換,將原始與精煉文本對轉換為結構化程式監督。
在監督品質提升與訓練分佈穩定方面,UltraX 採用低信心範例過濾與操作組合的比例控制採樣。在推理與執行階段,該框架透過滑動窗口預測、全局操作聚合及系統化後處理來規範並驗證模型輸出,從而提升大規模執行的穩定性與可靠性。實驗結果顯示,UltraX 在所有語料庫中達到了最高的平均效能,且以較少的訓練 Token 達到或超越基線,展現出更強的数据效率與精煉可靠性。
●開發者:可採用更高效的數據清理和增強方案來改進模型訓練
●投資人:數據品質優化成為新紅利,相關技術公司具有競爭優勢
●一般用戶:未來 LLM 模型的知識品質和性能可望進一步提升
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs ChatGPT:2026 搜尋與對話 AI 工具比較
深入比較 Perplexity vs ChatGPT 2026 版本,分析 perplexity 和 chatgpt 差異,解答 perplexity 好用嗎,並提供最佳 ai 搜尋工具推薦與選擇建議。
閱讀指南 →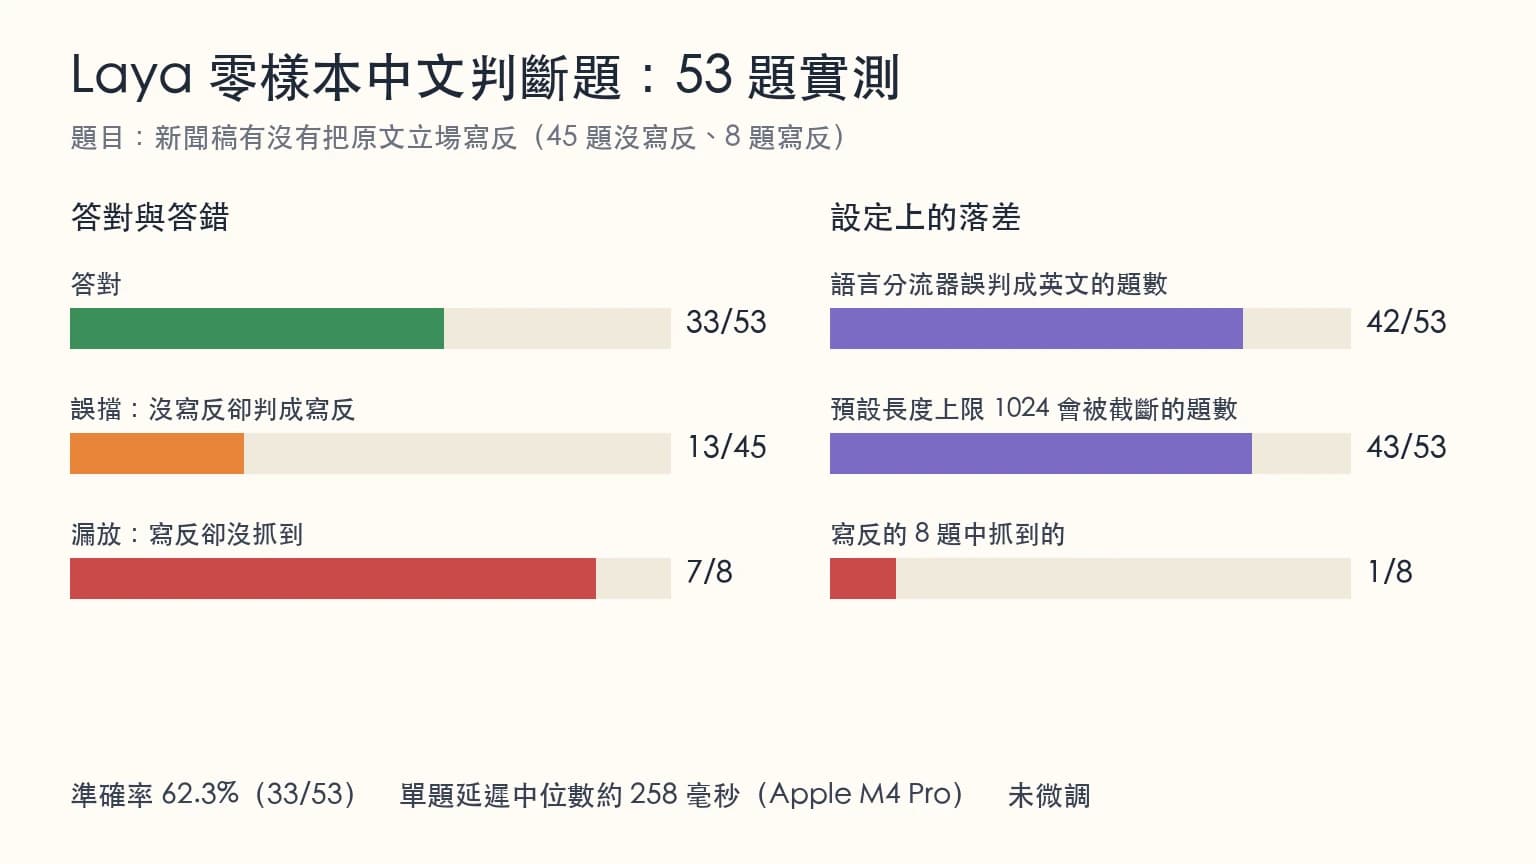
Laya 開源決策模型中文實測:零樣本 53 題判斷題結果
Laya 是 Apache 2.0 的開源決策模型,不生成文字、只做選擇題。我們用 53 題中文長文判斷題零樣本實測,記錄結果、設定陷阱與使用建議。
閱讀指南 →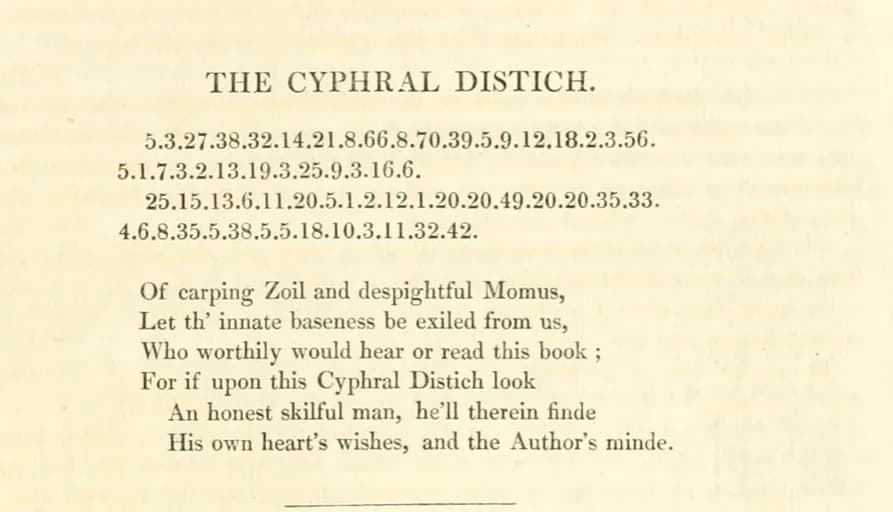
AI聲稱解開400年密碼「Cyphral Distich」:我們調閱原件逐字核對的結果
Vals AI 宣稱用 Fable 5.1 解開 Thomas Urquhart 400 年前密碼 Cyphral Distich,Reticuli 隨即提出反駁指其「未解」。我們調閱大英圖書館、1834年版與傳記三份原件逐字核對,找出雙方都沒點出的關鍵差異:兩邊用的是不同版本的底本。
閱讀指南 →🤖 本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。