安全倫理
LLM 安全對齐中的理解-遏制脱鉤:低資源孟加拉語貶低言論的安全漏洞
Aligned in Form, Not in Meaning: The Comprehension - Containment Decoupling of LLM Safety in Low-Resource Bangla Derogatory Speech

arXiv cs.CL2026-08-05
摘要
研究團隊審計了五個前沿大語言模型在孟加拉語貶低性言論上的安全表現,發現模型的安全對齐主要針對高資源語言的表面形式,而非有害含義本身。這導致模型在理解低資源語言污辱詞與遏制其使用上存在脱鉤現象,模型對孟加拉語的理解能力存在 7.92 個百分點的缺陷,同時語言洩露率卻保持一致的 92.83%,揭示了當前 LLM 安全防護的語言偏見問題。
●開發者:需重視多語言安全對齐的深層語義理解,避免依賴表面形式的防護
●投資人:AI 安全技術領域仍存在重大漏洞,相關安全解決方案具商機
●一般用戶:低資源語言使用者面臨更高的有害內容接觸風險
重要性評分
🟠 值得關注
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。
相關指南
Perplexity vs DeepSeek:AI 搜尋引擎與開發模型比較
Perplexity 與 DeepSeek 差異比較:Perplexity 附來源的 AI 搜尋與免費、Pro、Max 方案,DeepSeek 的 DeepThink、搜尋與依 token 計費的 API,幫你判斷 Perplexity 好用嗎、該選哪一個。
閱讀指南
Perplexity vs NotebookLM:AI 搜尋與筆記工具哪個更適合你?
Perplexity vs NotebookLM(現名 Gemini Notebook)比較:即時搜尋與來源引用、文件問答與音訊摘要、免費版額度與付費方案價格、企業版資料保護,以及 NotebookLM 上手步驟與兩者搭配的工作流程。
閱讀指南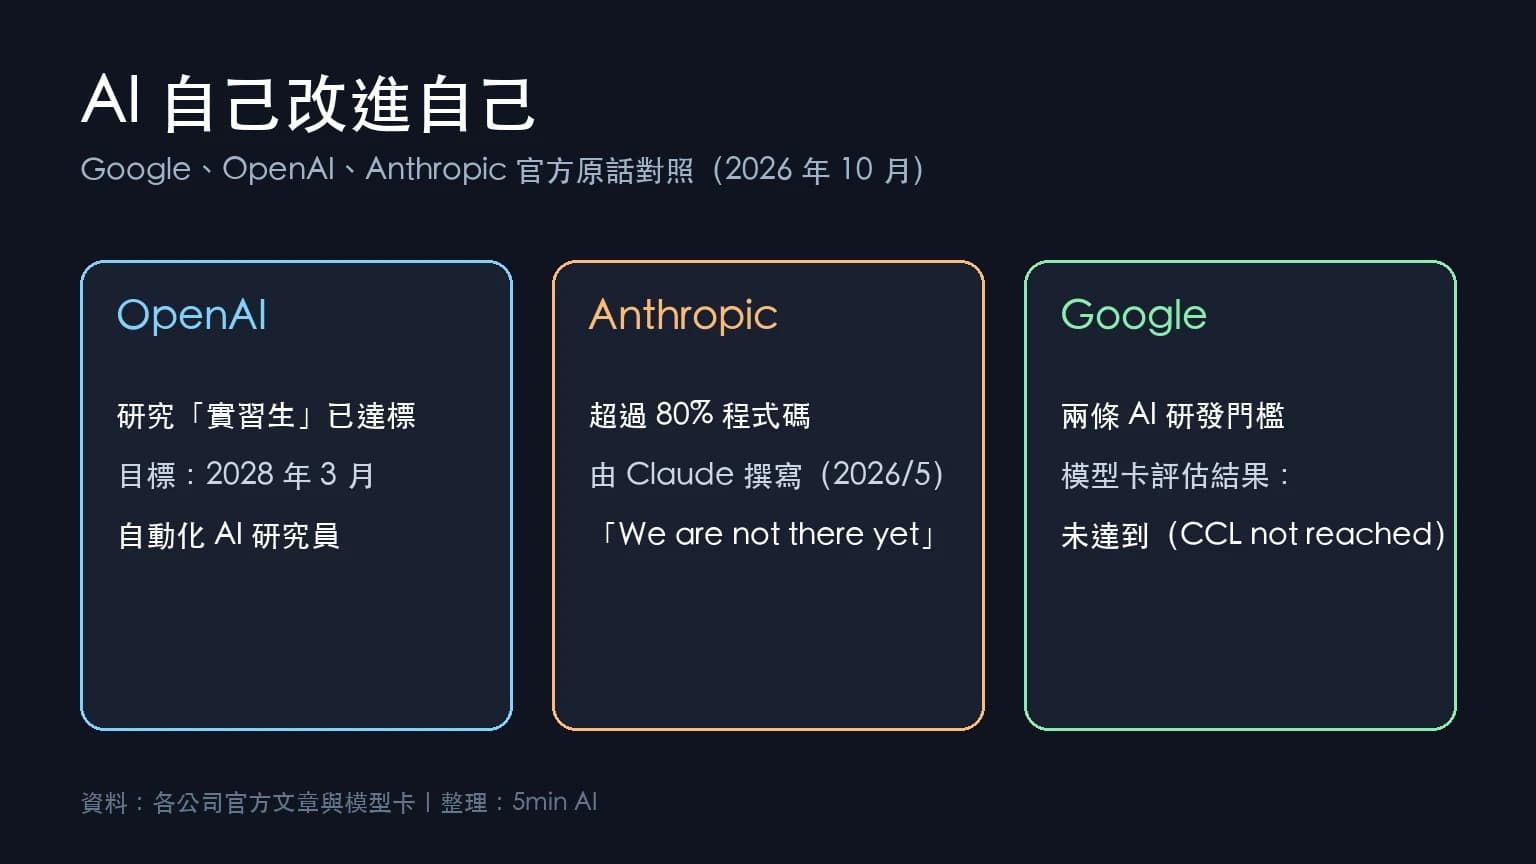
AI 自己改進自己(RSI):Google、OpenAI、Anthropic 官方到底說了什麼
OpenAI、Anthropic、Google 都在談 AI 參與研發下一代 AI(RSI)。整理三家官方文件的原話與數字,分開傳言與事實:誰說了什麼、誰說還沒到。
閱讀指南本文摘要由 AI 自動生成,內容源自原始報導。如有疑慮,請參閱關於我們。
喜歡這篇?每天早晨還有更多。
訂閱 5min AI,讓 AI 替你追蹤整個 AI 世界。